
Основы тестирования сетей TCP/IP для служб эксплуатации
Введение
Как показал практический опыт авторов, в профессиональной литературе в настоящее время слабо освещён, если вообще освещён, вопрос постоянного контроля в процессе эксплуатации качественных метрик услуг связи, предоставляемых на сетях TCP/IP. Если для задач проектирования или строительства этот подраздел отрасли имеется и даже иногда рассматривается в процессе создания реальной сети, то тестирование в процессе эксплуатации пускается обычно на самотёк и обязательно выполняется лишь при сдаче каналов и устройств в эксплуатацию. Проникновение же сетей TCP/IP сейчас практически повсеместное, с проблемами вида «вроде бы всё работает, но как-то далеко от ожидаемого», сталкивается практически каждый пользователь, операторы связи обычно разводят руками в этом случае, так как естественная юберизация отрасли, рост трафика вкупе с отсутствием чёткого понимания, что же происходит внутри оборудования, не дают им иного выбора. Для подробного рассмотрения данных вопросов мы и написали эту книгу.
Чем же сложна эксплуатация? Почему, например, у телефонистов в смежной подотрасли таких проблем обычно не возникает? Беда в первую очередь в том, что службы эксплуатации в операторах связи всегда рассматриваются как вынужденно несомый актив. Другими словами, деньги тратят, прибыли не приносят, хотят чего-то странного, что не вынесешь строкой бюджета, потому что слишком много умных слов, и хотелось бы в идеале избавиться от них вовсе, превратив в строку «абонплата» в договоре гражданско-правового характера как неизбежные издержки. В телефонии, где основные затраты приходятся на капитальное строительство, и где за более сто лет работы уже определились текущие расходы, это не слишком актуально. В сетях же TCP/IP, которые начинались как у нас, так и зарубежом с отдельных серверов, соединённых модемами, а сейчас выглядят как многостоечные дата-центры, это не так. Слишком быстро меняется оборудование, быстро меняются технологии, рост трафика если и не экспоненциальный, то всё равно чересчур активный. Служба эксплуатации и хотела бы всё успеть, но специалист по BSD/OS и модемам на 19200, актуальный буквально «вчера», уже не нужен в современном мире, ему приходится переучиваться, а это в свою очередь ведёт к привычке отбрасывать предыдущий пласт знаний в надежде, что новый будет более востребован на рынке труда. Иногда это ведёт к текучке кадров и желанию начальства всё отдать на поддержку, что только усугубляет проблемы. В сложившихся условиях активной замены оборудования и ограниченного финансирования эксплуатация сетей TCP/IP уходит с правильного индустриального пути автоматизации рутинных процессов, в том числе и проверки качественных метрик, и переходит на путь «ручного управления» многочисленными «рукоятками» настроек коммутаторов, маршрутизаторов, серверных стоек и прочего оборудования, чьё предназначение ясно уже не полностью. В странах, которые могут привлечь грамотную инженерную силу из всё ещё образованных стран, этот юберизированный подход купирует «болезнь» и даже создаёт вид, что всё благополучно. До поры, скажем честно. В России же нет такой возможности. Поэтому выход ровно один — вернуться на индустриальный путь и попытаться всё-таки автоматизировать процессы, чтобы там не писали модные журналисты в глянцевой прессе. Для этого надо углубиться в знания и «встать на плечи гигантов», как говорил Исаак Ньютон. С этого мы и начнём.
Соглашения, принятые в этой книге
Определение:
Определение 1
Понятие — отображённое в мышлении единство существенных свойств и отношений предметов
или
Определение 2
отображённое в мышлении единство существенных свойств и отношений предметов, если требуется математическая нотация.
Рисунок:
Рисунок 1. Изображение на плоскости, созданное графическими средствами
Важный текст:
Определение, понятие или особенность, на которую следует обратить внимание
Ссылки на определения, рисунки и другие понятия:
Данный текст хорошо иллюстрируется на рисунке 1.
К сожалению, на платформе author.today не поддерживается полноценная математическая нотация. Поэтому нам придётся использовать замену, доступную на этой платформе.
По возможности, мы будем использовать изображения, однако внутри текста это не всегда возможно.
T[i] – это запись, аналогичная использованию нижнего индекса при имени параметра.
* - знак умножения, там где в русской нотации его принято либо пропускать, либо использовать приподнятую точку.
/ - знак деления, там где в русской нотации принято использовать знак дроби
<= и >= - знаки «меньше или равно» и «больше или равно»
exists(T) – существование T
& - логическое «И»
| - логическое «ИЛИ»
floor(T) – округление T к меньшему
min(i=0,n,T[i]) – минимальный элемент выборки
max(i=0,n,T[i]) – максимальный элемент выборки
sigma(i=0,n,T[i]) – суммирование T с индексом от 0 до n
IF(условие, определение), IF(условие, определение)... - условное определение
Что мы ожидаем от читателя
Конечно, нам приятен абсолютно любой читатель, который интересуется сетями TCP/IP, поэтому мы постараемся в дальнейшем тексте следовать священным правилам Якова Исидоровича Перельмана и излагать даже сложное максимально доступно. Но читателю всё‑таки не следует путать байт с битом, секунду с пакетом данных и приём с передачей. На наш взгляд это несложно. Даже Википедия, как её не ругай, способна дать этот пласт знаний.
Основной же читатель, которому мы адресуем настоящую книгу, работает в службах эксплуатации сетей TCP/IP и MPLS. Он уже не первый год видит проблемы на сетях и часто имеет богатый опыт их устранения. Он технически грамотен, легко понимает причины и последствия, постоянно старается быть на переднем крае, хотя иногда не до всего доходят руки. Он — настоящий Связист с большой буквы. Можно сказать, что это наш коллега и друг, так как авторы отработали в операторах связи достаточно большой срок, чтобы наконец поделиться с миром, дабы их опыт не пропал втуне.
Базовые определения
Чтобы в дальнейшем тексте книги можно было использовать сокращённые наименования некоторых длинных понятий, введём несколько простых определений:
Определение 1
CE1 - оборудование пользователя, обеспечивающее нужные ему услуги и создающее запросы на соединение с иным оборудованием поверх сети оператора(-ов) связи
Определение 2
CE2 - оборудование пользователя, обеспечивающее нужные ему услуги и отвечающее на запросы к соединению, пропущенные поверх сети оператора(-ов) связи
Определение 3
PE1 - оборудование оператора связи, к которому непосредственно подключен CE1
Определение 4
PE2 - оборудование оператора связи, к которому непосредственно подключен CE2
Определение 5
P - транзитные устройства, обеспечивающие пользовательское соединение, как самого оператора, так и иных
Теперь объединим указанные определения на рисунке для наглядности:
Рисунок 1. Типовая схема сети связи
где
Пользовательское оборудование.
Операторское оборудование.
Канал связи между оператором и пользователем.
Транзитные каналы связи.
С помощью схемы на рисунке 1 можно описать в общем виде все типы сетей связи.
Раздел 1.1. Источники проблем на сетях связи вообще
В любой сети связи, будь то традиционная, с коммутацией каналов, или будь то «передовой» 5G основным источником проблем является конечность транзитной ёмкости. В простой схеме, приведённой на рисунке 1, услуга, предоставляемая пользователю в том или ином виде, использует последовательно каждое из устройств от начального до конечного. Для сетей коммутации каналов это запрос на соединение от CE1 до CE2, использование созданного соединения и разъединение. Для сетей TCP/IP это посылка пакетов, соответствующих выбранному протоколу, от CE1 до CE2 и обратно.
В любом случае между устройствами находятся каналы связи. И даже если их длина не слишком велика, ёмкость (или пропускная способность) конечна. Это может быть связано с физическими особенностями среды передачи, экономическими критериями и возможностями самого оборудования, формирующего конечную услугу. Причины в данном случае не слишком важны, их может быть и больше, важно понимать, что невозможно построить сеть без осознанно выбранного компромисса в целях принудительного ограничения ёмкости каналов. Даже при создании внутридомовой сети, когда казалось бы надо обеспечить себя любимых всеми нужными возможностями, мы так или иначе вынуждены ограничивать пропускную способность.
В результате, при запросе на соединение на сетях с коммутацией каналов, либо при пропуске трафика на сетях с коммутацией пакетов, может возникнуть ситуация, когда узкое место в сети не даёт возможности пропустить запрошенное. Конечно, выглядеть это будет по‑разному. На традиционных сетях в случае отсутствия свободной ёмкости на момент запроса соединения происходит отказ в обслуживании. Наиболее известным примером такого отказа, с которым встречались все, является сигнал «занято» в телефонной трубке. Если же ёмкости на момент запроса было достаточно, она фиксируется за пользовательским соединением на всё время до отключения. На пакетных же сетях происходит отбрасывание пакета, который невозможно поставить в очередь на отправку. Это может быть как пакет для создания соединения, так и с пользовательским трафиком уже созданного.
Что же касается ошибок, неизбежно возникающих на каналах связи ввиду помех либо неидеальности среды передачи, то данные для любых сетей в этом случае вынужденно доставляются с ошибками. Необходимо отметить, что помехи на каналах связи зависят от применяемой технологии. Известно, что оптические каналы более надёжны в этом плане, медные и коаксиальные — чуть менее, пропуск трафика по релейным каналам — ещё менее, а спутниковые каналы в период засветки можно считать рабочими только условно. В процессе доставки ошибочных данных результат может как транслироваться по сети в конечную точку, тем самым создавая «наведённые» ошибки, так и обрабатываться на месте возникновения. Помехоустойчивое кодирование выходит за рамки данной книги и должно быть рассмотрено отдельно. В целом, можно констатировать, что ошибки возникают заметно реже, чем выходы за пределы пропускной способности.
Ну и наконец, само оборудование так же может быть неидеальным и порождать дополнительные ошибки. Производитель оборудования обычно его тестирует перед продажей, однако это всё-таки не гарантирует 100% соответствия заявленным характеристикам. Тем не менее, для сетей связи с долгим циклом окупаемости и с длительной историей технического опыта, можно сказать, что выход за пределы производительности обычно происходит редко.
Таким образом, исходя из необходимости выдать готовые рецепты для служб эксплуатации, можно распределить отказы на сетях связи по важности следующим образом:
1. Наиболее часто возникают отказы ввиду отсутствия транзитной ёмкости.
2. Реже возникают отказы из-за ошибок на каналах.
3. Наиболее редки отказы оборудования, связанные с производительностью.
Раздел 1.2. Источники проблем на сетях TCP/IP
Дополнительно к уже описанному подробнее уточним причины появления отказов и их последствия уже применительно к рассматриваемым сетям. Схему соединений с рисунка 1 можно применять без изменений.
Здесь, для лучшего понимания, нам придётся погрузиться в историю. Стек TCP/IP был придуман не в самой отрасли связи, а в смежной — программировании. Изначальной его задачей было соединение компьютеров. Поэтому вопрос сохранения совместимости с уже работающими сетями связи, как например, пропуск голоса, перед архитекторами не стоял. Генераторами трафика должны были быть компьютерные программы. В качестве же каналов связи изначально использовались модемы. Эти особенности привели к достаточно раннему использованию технологии временного хранения данных перед передачей (то, что в англоязычной литературе называется store‑and‑forward). Кроме того, данная технология могла позволить легко организовать повторную пересылку при отсутствии подтверждения доставки от получателя, что в условиях ненадёжных каналов являлось хорошим подспорьем.
Дополнительной архитектурной особенностью сетей TCP/IP стал программный интерфейс для создания соединений по сети. Он был отвязан от знаний о будущей среде передачи и для программы выглядел как некая «труба» произвольной ёмкости, в которую с одной стороны помещались данные, а с другой — извлекались. Поэтому в теории программа‑инициатор соединения могла занять весь доступный канал, а честный арбитраж между программами возлагался на сам стек. В традиционных сетях связи оборудование специально проектировалось под нужную задачу, здесь же программы были общего назначения, а операционные системы проектировались многозадачными, поэтому вопрос арбитража трафика становился особенно необходимым.
Ещё одной специфической характеристикой сетей TCP/IP является сознательный выбор архитекторов эквивалентности между любыми устройствами сети. То есть для одних целей точка CE может становиться PE или P, а для других сохранять роль CE. При том встаёт вопрос — как хранить транзитные соединения, не относящиеся к собственным. Скорее всего в целях экономии ресурсов, была выбрана модель хранения состояния соединения только на конечных точках (CE1 и CE2), а на транзитных подобное знание отсутствует, и они просто пропускают трафик согласно установленным маршрутам, при этом, разумеется, возможен и «мусорный» трафик.
Не будем забывать, что основной единицей передачи в стеке TCP/IP является пакет данных. Учитывая всё вышеизложенное, попытаемся повторно решить за архитекторов важный вопрос: что делать с теми пакетами, которые либо не помещаются в очередь, хотя уже сформированы для отправки программой, либо по арбитражу ядром стека фиксируются как излишние, либо по маршрутным таблицам отсутствует следующая транзитная точка доставки. В традиционных сетях с коммутацией пакетов подобные случаи приводят к так называемым «отказам», которые транслируются на конечные точки соединений CE1 и CE2. В сетях же TCP/IP подобная «трансляция» весьма ограничена, а вопрос «мусорной» загрузки каналов с невысокой пропускной способностью встал ещё при первых опытах. Иногда самая простая идея — самая эффективная. Поэтому решение, которое просится первым, и было выбрано в итоге, став своего рода фирменной особенностью стека TCP/IP. А именно:
«Если пакет по каким-то причинам не может быть добавлен или доставлен, его следует просто отбросить»
Теперь, понимая все эти особенности, начнём учитывать источники создания проблем для пользовательского трафика.
При создании запроса на соединение от CE1 к CE2 на рисунке 1 имеются следующие потенциальные точки отказа:
a. нет маршрута от CE1 к CE2,
b. не хватает места в очереди на отправку данных к PE1,
c. нет свободной ёмкости в канале между CE1 и PE1,
d. не хватает места в очередях на приём в PE или P,
e. пакет принят с ошибкой на приёме,
f. нет маршрута к CE2 на PE или P,
g. не хватает места в очереди на отправку от PE или P,
h. нет свободной ёмкости в канале от PE или P,
i. не хватает места в очередях на приём в CE2,
j. пакет принят с ошибкой на приёме,
k. нет процесса, который отвечает на CE2 за выбранный на CE1 сервис.
Видно, что точки a, b, d, f, g, i , k сразу ведёт к событию «потеря пакета».
Точки c и h так же опосредованно ведут к тому же. При этом, заметим, не каждая среда передачи умеет заранее это сообщать.
А в точках e и j формируются события ошибок на канале. В современных условиях это достаточно большая редкость ввиду применения нужных технологий на физическом уровне, однако, всё-таки встречается. События ошибок также ведут к потере.
С учётом того, что со времён создания сетей TCP/IP по нынешнее время, основным устройством пропуска трафика является маршрутизатор, имеющий предком компьютер общего назначения с многозадачной операционной системой, перегрузка любой точки c рисунка 1 ввиду нехватки ресурсов процессора или памяти для обработки трафика не только возможна, но и достаточно часто встречается в реальной жизни. Не забудем, что проектирование сетей TCP/IP и миграция между поколениями оборудования всё ещё далеки от индустриального пути, и по большей части служба эксплуатации остаётся один на один с одним из производителей, который часто и сам слабо представляет себе, сколько именно пользовательского трафика нужного вида может пропустить NoName XX-1029-VV в реальных условиях, а не в лаборатории. Это также источник потерь.
Резюмируя вышенаписанное и памятуя, что основной читатель — служба эксплуатации, мы можем распределить отказы на сетях TCP/IP по важности следующим образом:
1. Наиболее часто возникают отказы ввиду отсутствия транзитной ёмкости.
2. Отказы из-за ошибок на каналах и отказы оборудования, связанные с производительностью, можно рассматривать вместе.
3. Обе данные причины ведут в первую очередь к потерям пакетов.
Раздел 1.3. Методы борьбы и основные определения
Поскольку проблемы мы описали, теперь поговорим об общих принципах борьбы. Начнём с вопроса компенсации нехватки транзитной ёмкости. Остальные проблемы рассмотрим позже, ввиду их меньшей значимости. Очевидно, что создать сеть, которая удовлетворила бы всех, скорее фантастика, чем реальность. Тем не менее, перевод потоков трафика с загруженного маршрута на недогруженный, ввод дополнительных каналов связи в нужном направлении — это разумный выбор реагирования, позволяющий снизить проблему нехватки транзитной ёмкости до приемлемого уровня. Ещё одним методом борьбы является разделение пользовательского трафика по приоритетам. Например, критичный трафик для министерства по чрезвычайным ситуациям оператор пропускает по своей сети в первую очередь, коммерческий трафик для премиального сегмента пользователей — во вторую, а всё остальное — в третью.
Как же работники службы эксплуатации могут определить, что пора вводить ёмкости, перенаправлять трафик или расставлять приоритеты? В этом им помогают метрики качества.
Определение 6
Метрика качества - измеряемая характеристика сети TCP/IP как цельного материального объекта, полученная в результате статистического наблюдения с использованием технических средств.
Сразу заметим, что ни в коем случае нельзя путать метрики качества и физические величины. В сетях TCP/IP только время является той физической величиной, которая в теории доступна к полноценному измерению так, как это принято в метрологии — путём вычисления отношения измеряемой величины к эталону. Впрочем, на практике даже время правильно, то есть с помощью поверенных средств измерений, вычислено быть, как правило, не может. Так как экономический паллиатив реального общества рекомендует строить сети в первую очередь для пропуска пользовательского трафика и, соответственно, получения прибыли оператором, а не для повсеместной установки средств измерений. Маршрутизаторы же, которые являются основными устройствами обработки трафика, в основном произошли от компьютеров общего назначения с той или иной операционной системой. К метрологии они не имеют отношения, и бывает так, что даже точность хода их внутренних часов оставляет желать лучшего, хотя как раз основную свою задачу они выполняют блестяще.
Что же касается остальных физических величин, как основных, так и производных, то к качеству услуг, предоставляемых сетями TCP/IP имеет хоть какое-то отношение разве что частота, и то опосредованно. Поэтому мы оставим другим авторам возможность сказать что‑то на эту тему.
Определение 7
Статистическая величина - количественная характеристика размеров явлений, их соотношения, степени изменения, взаимосвязи.
Итак, все метрики качества являются статистическими величинами. И в связи с этим для них, разумеется, невозможно создать эталон. Даже если на ваших глазах вышло свежее постановление правительства всей Галактики Млечный Путь, регламентирующее создание эталона коэффициента потерь пакетов, помните, что это всего лишь один из «четырёхсот сравнительно честных способов отъёма денег», над научным применением которых человек с пытливым умом может разве что посмеяться. К эксплуатации это не имеет отношения, оставьте общение с подобными текстами своему юридическому отделу.
Определение 8
Статистическое наблюдение - сбор сведений, заключающийся в регистрации признаков и фактов, которые характеризуют каждую единицу исследуемой совокупности.
Раз есть статистическая величина, следовательно есть и статистическое наблюдение, по результатам которого проводятся вычисления. Над чем же оно ведётся? Вспомним учебники: на сетях TCP/IP в вырожденном случае может и не быть трафика вовсе. Что же нам будет известно о построенной сети без трафика? Если ни одна программа не выдала запрос на соединение по любому из поддерживаемых протоколов, то никаких потерь и тем более пропускной способности мы не увидим. Конечно, можно попытаться теоретически рассчитать, например, время доставки пакетов по транзитной канальной ёмкости и их длине, но, во-первых, при этом не будут учтены другие важные части времени доставки, такие как время обработки на транзите или время разделения по приоритетам, во-вторых, одним временем нельзя ограничиваться. а в-третьих, на практике в реальной сети время доставки может отличаться в силу того, что маршруты часто перестраиваются автоматически, и путь доставки может быть не тем, который рассматривался в теории. Потери же или пропускную способность возможно получить только с реальной сети и только пропуском трафика. Поэтому сбор метрик качества правильно вести с помощью пропуска трафика.
Определение 9
Генеральная совокупность - совокупность всех признаков и фактов, относительно которых предполагается делать выводы. Для нашего статистического наблюдения — это весь трафик, пропущенный по сети.
Теперь рассмотрим важный вопрос — следует ли использовать весь трафик для расчёта метрик качества? С одной стороны, весьма заманчиво рассчитать характеристики для всех соединений, имея так сказать, полную картину поведения. С другой получается, нужно отслеживать все потоки всех пользователей, а их число довольно велико, при этом потребуется «накрыть» весь периметр сети для этого. С третьей, всю статистику надо где-то хранить и, это что же получается, нужны заметные дополнительные объёмы средств хранения? С четвёртой, служебный трафик передачи рассчитанных метрик может быть велик на критически важных, но в то же время узких направлениях. Таким образом, это несколько неразумный подход. Правильный выход нам подсказывает наука статистика.
Определение 10
Выборка - часть генеральной совокупности элементов, которая охватывается наблюдением. Для нашего статистического наблюдения — это часть трафика, пропущенного по сети.
Итак, в условиях развитой сети, для получения метрик качества разумнее всего делать статистическую выборку среди всех пропущенных пакетов. Как же сделать выбор, чтобы сохранить репрезентативность? Для этого нужно вспомнить начало раздела. Зачем нам нужны метрики? Для возможности «расшивки» узких мест. Если на каких-то точках присутствия есть прочный запас по канальной ёмкости и производительности оборудования, там некоторое время вполне можно обойтись и без измерений. Даже делая выборку из каждого тысячного пакета в реальном пользовательском трафике на таких точках, мы получим несколько бесполезную информацию. А служба эксплуатации должна быть информативной, вы же помните этот принцип? Может быть. лучше всего пойти путём традиционных статистических исследований и выбрать нужные пакеты с помощью псевдослучайной последовательности? Это ничем не лучше каждого тысячного пакета. Но наука уже придумала выход — приблизительным аналогом предлагаемого рабочего решения может служить социологический опрос. Среднего человека обычно никто не спрашивает, что он думает о повышении цен, тем не менее, раз в пятнадцать-двадцать лет принудительный опрос отдельного индивидуума позволяет распространить получаемые результаты на всё население.
Исходя из изложенного на наш скромный взгляд наилучшими практическими свойствами обладает следующая выборка — тестовый трафик от точки создания до точки получения, созданный искусственно. Можно, конечно, пуститься в длительные дискуссии на симпозиумах по поводу корректности использования как выборки из генеральной совокупности явно искусственно созданного трафика, но мы не ставим перед собой задачу строгого математического доказательства репрезентативности предложенной выборки. Задача книги — дать экономически обоснованное решение, а не переливать из пустого в порожнее. Мы занимаемся отслеживанием качества 15 лет и за это время имели возможность неоднократно убедиться, что пропуск тестового трафика как источник метрик более чем практичен. При этом не слишком подвержен ложно‑отрицательным срабатываниям.
Раздел 1.4. Создание искусственного трафика
Определение 11
Тест - трафик от точки создания до точки получения, созданный искусственно и предназначенный для расчёта метрик качества сети.
Теперь пристально займёмся определениями, без которых дальше двигаться сложно. В условиях эксплуатации важно опережающим образом обнаруживать проблемы на сети, поэтому полное время генерации искусственного трафика (выборки) должно быть ограничено. Иначе мы можем получить ситуацию, аналогичную традиционному BER‑тестированию, когда его время настолько велико, что может быть рекомендовано только на этапе сдачи каналов. Не ошибёмся, если скажем, что совокупное время тестирования не должно превышать 60 секунд, это разумный компромисс между быстротой поступления информации к службам эксплуатации и достаточно длительным пропуском трафика, позволяющим накопить статистику. В то же время понижение данного порога до 10 секунд мы вынуждены рассматривать как слишком быстрое тестирование, могущее не дать правильной картины. Кстати говоря, отраслевой стандарт Y.1540 тоже рекомендует такой же период и в этом мы с ним согласны.
Определение 12
период времени пропуска искусственного трафика.
Помимо этого порога при измерениях существует ещё один, даже более важный. В конце-концов, T[test] можно сделать и зависимым параметром, а вот время принятия решения — это ключевая характеристика для выборки, даже если не использовать искусственный трафик. Что это такое? Дело в том, что после посылки пакета с точки создания его доставка в точку назначения, разумеется, не гарантирована (см. выше историю TCP/IP в разделе 1.2). Как в авиации существует скорость принятия решения, когда командир воздушного судна обязан выбрать, продолжает он взлёт или нет, так и в нашем случае существует время принятия решения, когда в точке доставки происходит окончание ожидания очередного пакета и фиксируется потеря.
Определение 13
период ожидания прихода очередного пакета.
В отраслевом стандарте Y.1540 время T[max] так же вводится. Однако там оно ограничено для событий потерь пакетов. Мы же не согласны со столь узким видением и распространяем этот параметр на большее число качественных метрик. В то же время с рекомендацией в качестве времени ожидания использовать порог в 3 секунды мы согласны.
Теперь, поскольку в качестве выборки мы планируем использовать искусственно создаваемый трафик (тест), а итоговые метрики напрямую зависят от генератора, опишем его параметры. Заметим, что трафик не должен быть вида TCP по очевидным причинам, которые мы здесь опустим, а когда будет возможность, опишем их.
Определение 14
полезный размер пакета теста внутри протокола UDP или ICMP.
Определение 15
размер служебных данных пакета теста. Для IPv4‑пакетов, передающихся через Ethernet, это 28 байт. Для IPv6‑пакетов, передающихся через Ethernet, это минимум 48 байт.
Определение 16
число пакетов в тесте.
Определение 17
скорость генерации теста.
Определение 18
класс сервиса (TOS/DSCP) теста.
В некоторых случаях принято использовать межпакетный интервал для создания искусственного трафика, однако практический опыт работы операторов связи показал, что инженерный состав хорошо понимает понятие скорости генерации трафика и одновременно слабо связывает между собой межпакетный интервал и скорость генерации, хотя в реальности они напрямую зависят друг от друга. Поэтому для лучшего понимания службами эксплуатации мы в дальнейшем будем использовать скорость генерации. Для пытливых умов приведём связь.
Определение 19
межпакетный интервал при генерации искусственного трафика.
Обращаем внимание, что межпакетный интервал описывает не период времени между окончанием передачи очередного пакета и началом передачи следующего, как можно подумать из его названия, схожего с межпакетным промежутком, а период между началами передачи очередного пакета и следующего. Лучше всего это видно на шкале времени на рисунке 2.
Рисунок 2. Межпакетный интервал, межпакетный промежуток
где PD – время передачи пакета в физическую среду, IPG – межпакетный промежуток, IPI[s] – межпакетный интервал.
В реальности скорость генерации и зависящий от неё межпакетный интервал не могут быть совсем уж произвольными. Допустим, если в порт стандарта 10Base-T направлять трафик от генератора со скоростью 100 Мбит/с, то межпакетный интервал и итоговая скорость передачи начнут зависеть не только от генератора, как красиво выглядит на рисунке 2, но и от поведения соседних устройств, могущих создавать коллизии или от точности хода часов таймера, если передача от пользовательской программы отложена операционной системой по каким‑либо причинам. Поэтому, повторимся, мы и используем термин статистическая величина, так как факторов влияющих на трафик в сети достаточно много. Эталона быть не может априори! Впрочем, описанных параметров полностью достаточно для создания исходящего трафика на стороне инициатора. Отметим только, что период времени пропуска искусственного трафика T[test] может быть выражен через остальные параметры по формуле
Теперь займёмся стороной приёма.
Раздел 1.5. Приём искусственного трафика
Очевидно, что все метрики качества на сети TCP/IP по итогам теста могут быть вычислены только после приёма пакетов, созданных на стороне передачи. Так же ясно, что время ожидания на приёме должно быть конечно, чтобы была возможность подвести итоги и создать возможные реакции. Сразу заметим, что в дальнейшем мы неявно предполагаем, что часы на обоих устройствах, занимающихся обработкой теста. должны быть синхронизированы. Это удобно для точности определений, хотя строго говоря, для расчёта большинства метрик качества необязательно.
Определение 20
абсолютное время начала отправки пакета с номером i от стороны генератора.
Определение 21
абсолютное время окончания приёма пакета с номером i на стороне приёма.
Следующие два определения ссылаются друг на друга, поэтому мы их вводим рядом, для лучшего понимания.
Определение 22
число пакетов теста, успешно принятых на стороне приёма за время T[r]
Определение 23
период времени приёма теста.
«Почему так сложно? У нас тут что — кружок любителей математики?» - спросит пытливый читатель. Не станем делать секрета, ведь мы ценим пытливого читателя. Одной из основных особенностей сети TCP/IP является асинхронный характер трафика. Программа‑инициатор создаёт пакет в произвольный момент времени, и вообще говоря, мы ничего не знаем про то, в какой именно момент. Это же относится и к тестовому трафику, да‑да‑да! Даже на транзитных P‑устройствах эта особенность сохраняется. Таким образом, на приёме с одной стороны, необходимо получить все пакеты теста, с другой стороны, не все пакеты могут быть доставлены. Вы ведь помните про потери? При этом полный период тестирования T[test] использовать нельзя, так как он определён на стороне инициатора, а для приёмной он может и будет зависеть от реального состояния сети. При наличии буферизации период приёма может даже уменьшиться! А если первый пакет теста не будет доставлен, то ориентироваться на кажущийся на первый взгляд очевидным финальный временной порог ожидания всех пакетов T2[1] + T[test] тоже никак нельзя. При пропуске же заметного числа пакетов в середине тестовой последовательности искусственного трафика, ситуация только ухудшается.
Поэтому наиболее практичным подходом для служб эксплуатации будет следующий алгоритм 1, который весьма прост в реализации и при достаточном количестве пакетов в тесте позволяет получать корректные статистические величины. Если же у читателя есть своё мнение, мы приглашаем его к дискуссии, к которой всегда готовы. Итак:
Алгоритм 1
1. На очередном шаге ждём не более T[max]
2. Если пакет не пришёл, остальные возможные пакеты считаются недоставленными. Переход на шаг 6.
3. Иначе рассчитываем метрики качества.
4. Если число принятых пакетов стало равно N[s], все пакеты теста доставлены, переходим на шаг 6.
5. Иначе возвращаемся на шаг 1.
6. Останов.
Несложно видеть, что T[r] с помощью алгоритма 1 легко получается именно в форме определения 23. И также несложно видеть, что у алгоритма есть важные условия применимости. Как в теории дифференциальных уравнений в задаче необходимы граничные условия, так и в теории расчёта метрик качества сетей TCP/IP нужно чётко понимать, где заканчиваются границы корректности даже у статистических величин.
Условие применимости 1 алгоритма 1
C[s] класс сервиса TOS/DSCP за всё время работы теста на стороне инициатора не меняется
Это вполне логичное требование. Ведь мы собираемся тестировать трафик разного вида. Пользователь, используя приложения, критичные к задержкам, вправе использовать нужные метки пакетов (конечно, если он закупил у оператора связи соответствующий сервис). Поэтому, проверяя как готовность сети, так и возможные узкие места на всём транзите, мы должны метить и тестовый трафик правильным образом. И уж, конечно, выбранный класс нужно использовать всё время тестирования. Если же хочется полной картины для всех классов, то следует всего лишь провести несколько тестов в каждом требуемом классе.
Условие применимости 2 алгоритма 1
P[s] размер пакета за всё время работы теста на стороне инициатора не меняется
Это условие уже не такое очевидное. Многочисленные отраслевые стандарты (например, RFC-2544) обычно рекомендуют для теста использовать пакеты разных размеров, мотивируя это тем, что пользовательский трафик различен и, дескать, результат должен показывать сразу всю картину. Не отрицая факта различия размеров в пользовательском трафике, мы тем не менее готовы задать встречные вопросы:
Если пропускать трафик с разными размерами пакетов в одном потоке, то мы получим общие метрики, а как тогда отделять случаи потерь пакетов определённого размера, что достаточно часто встречается на практике?
А если рассчитывать метрики для каждого размера пакетов отдельно, то чем этот случай отличается от нескольких потоков с фиксированным размером в течение всего теста?
Кроме того, не забываем, что в стандарте RFC-6815 впрямую рекомендуется применять RFC-2544 только в отделённой среде тестирования (Isolated Test Environment), поэтому в службах эксплуатации рабочих сетей мы бы рассматривали RFC-2544 как хотя и полезный, но не строгий, а более факультативный.
Резюмируя и памятуя предыдущее условие применимости 1, можно сказать, что практической полезностью обладает именно фиксация размера пакета на всё время теста. Если же хочется полной картины для всех размеров, то следует всего лишь провести несколько тестов с каждый требуемым размером.
Условие применимости 3 алгоритма 1
N[s]>=200 число пакетов в тесте должно быть достаточным для расчёта метрик с нужной точностью
Наш коллега‑читатель уже догадывается, что мы скажем. Процент потерь пакетов от точки создания трафика до точки приёма имеет в знаменателе число пакетов в тесте (см. ниже определение 24). Поэтому чем больше пакетов пропущено, тем точнее будет эта метрика. Что же касается остальных, то число пакетов для них тоже имеет значение, поэтому не стоит тестировать качество слишком незначительным числом пакетов.
Кроме того, для тех работников операторов, которые предпочитают не число пакетов в качестве первичного параметра, а время тестирования, приведём формулу вычисления N[s] по остальным параметрам:
Проверим корректность типовыми настройками генератора. Воспользуемся знакомыми терминами.
При пропуске трафика IP‑телефонии с использованием кодека G.729 скорость для адресации IPv4 будет 24 килобита/с, размер пакета 32 байта, время тестирования выберем в 20 секунд. Число пакетов получается 1024. Более чем достаточно для достойной точности.
При пропуске трафика IP‑телефонии с использованием кодека G.711 скорость для адресации IPv4 будет 79 килобит/с, размер пакета 172 байта, время тестирования выберем в 20 секунд. Число пакетов получается 1011. Тоже вполне достаточно.
Условие применимости 4 алгоритма 1
скорость генерации теста должна быть такой, чтобы двойной межпакетный интервал не превышал T[max]
Вот тут потребуются более подробные разъяснения. Когда мы собираемся получать тестовый трафик даже при большом числе потерь в сети, нам потребуется, чтобы периоды ожидания в процессе приёма были конечны и не превышали T[max]. Этого можно добиться, если поставить достаточно большую скорость передачи. В предположении, что на сети может быть 50 процентов потерь пакетов (в реальности это очень плохо, сеть близка к гибели) мы должны создавать трафик более быстро, чем он будет теряться, чтобы алгоритм 1 на приёме успел получить хотя бы часть тестового трафика.
Проверим разумность формулы. Воспользуемся уже знакомыми параметрами. 32 байта кодека G.729 при рекомендованном времени ожидания 3 секунды дают минимально нужную скорость в 320 бит/с. Разумный минимальный выбор, реальность (см. выше условие применимости 3) быстрее более чем в 70 раз.
Проверим иначе. Возьмём произвольный протокол с размером пакета 1472, а время ожидания оставим тем же. Получаем 8000 бит/с минимально необходимой скорости. Это 1,5 секунды межпакетного интервала. То есть при потере двух пакетов подряд (вполне реальный случай) алгоритм завершится заранее. Что приведёт к недостаточной точности итоговых статистических величин. Видим, что условие применимости 4 абсолютно разумно. В реальных случаях тестирования, исходя из своей практики, мы рекомендуем использовать как минимальную скорость 32768 бит/c, чтобы купировать возможные всплески потерь.
Условие применимости 5 алгоритма 1
B[s] не должна превышать физические скорости интерфейсов аппаратной платформы
Это простое и разумное требование. Предлагаем читателю доказать его необходимость самостоятельно. А мы, после длительной подготовки, наконец начнём определять метрики качества.
Раздел 1.6. Первичные метрики
И вот, когда рассказано очень многое, можно начать наконец-то описание метрик качества, про которые мы так долго говорили, прямо как большевики на втором съезде Советов. Вначале упомянем основные. Первая из них очевидна:
Определение 24
процент потерянных пакетов в тесте.
Памятуя, что нельзя быть математиком, не будучи в то же время и поэтом в душе, зная что формулы воспринимаются многими людьми хуже, чем наглядные примеры, покажем на рисунке откуда берётся эта метрика.
Рисунок 3. Сеть связи, на которой произошло событие потери пакета.
где
Пакеты пользовательского трафика, направленные от CE1 до CE2.
Узкое место на сети оператора связи, в котором нет свободной ёмкости в момент пропуска одного из пакетов.
Событие отбрасывания одного из пакетов пользовательского трафика, который невозможно доставить из-за отсутствия свободной ёмкости.
Пакеты пользовательского трафика, доставляемые по сети оператора связи после события потери одного из пакетов.
На рисунке 3, конечно, число изображённых пакетов условное, в реальности их намного больше даже для тестового трафика (см. условие применимости 3), что уж говорить про пользовательский — их там без счёта. Тем не менее, даже если посчитать по рисунку, поставив N[s] в 4, а N[r] в 3, получим LR[r] равным 25%. Нормальное же значение конечно должно быть 0%, что очевидно, как из рисунка, так и из логики. Впрочем, это в идеальном мире. О реальных нормах мы ещё поговорим.
Теперь упомянем то, что на практике слишком редко проверяется, однако на самом деле имеет очень большое значение в рабочих сетях с разделением трафика по классам сервиса:
Определение 25
число пакетов теста, успешно принятых на стороне приёма за время T[r], однако доставленных с классом сервиса, отличным от C[s]
Определение 26
процент пакетов в тесте, доставленных с изменённым классом сервиса (процент перекраски).
Тут уже точно не обойтись без наглядности. Рекомендуем внимательно изучить весь рисунок, не зря же мы его создавали!
Рисунок 4. Сеть связи, на которой произошли события потери и изменения класса сервиса.
где
Пакеты пользовательского трафика, направленные от CE1 до CE2, помеченные пользователем классом сервиса C[s].
Узкое место на сети оператора связи, в котором есть свободная ёмкость для пропуска пакетов вообще, но нет свободной ёмкости для пропуска пакетов запрошенного пользователем класса сервиса C[s]. Политика же пропуска трафика предполагает не отбрасывание таких пакетов, а понижение приоритета.
Событие понижения приоритета одного из пакетов пользовательского трафика для дальнейшей доставки.
Доставка пользовательских пакетов без дальнейших изменений класса ввиду наличия свободной ёмкости.
На рисунке 4, вновь число изображённых пакетов условное. Но мы всё-таки для наглядности посчитаем с карандашом в руках, что N[rr] равно 1, а N[r] , как и прежде 3, и получим RR[r] равным 33,(3)%. Нормальное же значение конечно должно быть 0%. По крайней мере на сети оператора связи, который себя и клиентов уважает.
Почему данная метрика настолько важна, что мы её упоминаем второй? У тех операторов связи, которые борются за качество услуг, несомненно, уже внедрён на рабочих сетях пропуск трафика с учётом приоритетов. Иначе говоря, важнейший трафик обрабатывается P‑устройствами в первую очередь, менее важный во вторую, а трафик любимой социальной сети простого жителя Красного города‑сада — только тогда, когда для него есть свободная канальная ёмкость. Операторам же, которые ещё только думают, не сделать ли этот шаг, мы настоятельно рекомендуем шагнуть навстречу будущему быстрее.
Когда происходит разделение трафика по приоритетам, в политике контроля обычно указано, какая доступная полоса пропускания выделяется в канале для трафика определённого класса. Это может делаться как в абсолютных цифрах, путём указания максимальной скорости в битах в секунду, так и в относительных — установкой процентов об общей полосы. Дополнительно к этому, для каждого класса в политике указывается, что делать, если очередной пакет при подсчёте уже занятой полосы превышает порог. Его можно либо отбросить, как это делается при нехватке канала стеком TCP/IP (см. выше в разделе 1.2), либо понизить приоритет, и попытаться пакет всё-таки доставить, если, конечно, для более низких классов есть нужная ёмкость канала.
В тех случаях, когда на сети фиксируется перекраска трафика, значит где-то есть узкое место в политиках профилирования. На рисунке 4 это место отмечено фиолетовым цветом. Пользователь пока ещё не видит проблемы и это логично, ведь пакеты‑то доставлены, однако служба эксплуатации на появление ненулевой метрики RR[r] обязана реагировать, тем более, если этот факт уже не первый раз повторяется. Он может свидетельствовать как минимум о трёх вещах: либо пользователь выбрал заказанную полосу пропускания в классе сервис C[s], и ему требуется дополнительная, либо пользователь по недосмотру или намеренно пропускает неверный трафик, надеясь, что оператор добрый за свой счёт, либо на одном из транзитных каналов политика профилирования исчерпала свою ёмкость и тут уже оператору пора решать, что делать на данном участке. Как вы видите, метрика очень важная, но среди многочисленных сетевых администраторов, которых встречали на своём жизненном пути авторы, к сожалению, только у некоторых было понимание аналогичное нашему, поэтому мы и делаем на этом акцент. Надеемся подвижничеством добиться правильного, как сказано у Мф.7:7.
Отойдём от нетривиального и упомянем уже очевидное:
Определение 27
измеренная скорость среди успешно принятых пакетов на стороне приёма за время T[r]
Этой характеристикой пользуются все, даже рядовые пользователи, поэтому она не должна вызывать вопросов. Но рисунок мы всё-таки приведём. Ибо связист в России больше, чем поэт!
Рисунок 5. Сеть связи, на которой производится измерение скорости.
где
Измеритель скорости.
Мы не зря использовали в качестве символа измерителя стилизованное изображение прибора. Поскольку, как в скоростемере локомотива, так и в спидометре автомобиля стрелка заметно подрагивает, отражая своим поведением неточности в измерениях. На сети связи происходит так же, хотя физические причины здесь конечно иные!
Поэтому, хотя данная метрика и понятна большинству пользователей без перевода, что уж говорить о службах эксплуатации, на наш взгляд измеренная скорость обладает ценностью, только когда проводится нагрузочное тестирование (см. ниже). Без этого параметр, разумеется, не окончательно бесполезный, поскольку сравнивая BW[r] с B[s] можно получить небольшую дополнительную информацию по итогам теста.
Однако, заметим, скорость на приёме явно будет зависеть от количества потерь по пути следования пакетов. Более того, мы ожидаем, что на хорошо отстроенной сети должна быть корреляция между LR[r] и (B[s]-BW[r])/B[s]. Разумеется, с учётом некоторой неопределённости, вносимой периодом T[max] и распределением потерь. Что же касается нормального значения для скорости, мы более внятно погорим об этом, обсуждая нагрузочное тестирование.
Из основных метрик остались задержки, их тоже знают все:
Определение 28
минимальная задержка успешной доставки пакетов от стороны генератора до стороны приёма, измеренная за время T[r].
Определение 29
максимальная задержка успешной доставки пакетов от стороны генератора до стороны приёма, измеренная за время T[r].
Определение 30
среднее арифметическое задержек успешной доставки пакетов от стороны генератора до стороны приёма, измеренных за время T[r].
Не откажем себе в удовольствии проиллюстрировать и эти метрики наглядным рисунком.
Рисунок 6. Сеть связи, на которой производится измерение задержек.
где
Накопитель информации о параметрах T1[i].
Накопитель информации о параметрах T2[i] для измерения задержек.
В качестве символа измерителей времени выбрано условное изображение часов, так как в реальности именно с помощью внутренних часов (точнее таймера) и происходят измерения. Мнениям иных авторов, что следует использовать только специализированное оборудование, так как якобы внутренние часы устройств недостаточно верны, мы бы не доверяли. В определении 6 мы сказали практически всё необходимое на эту тему и повторять аргументы смысла не видим.
А вот вопрос стоит ли измерять все указанные задержки или следует ограничиться только средним, вопрос интересный, дискуссионный и для кого-то, возможно, даже пахнет кандидатской. Пока мы полагаем, что стоит измерять все указанные виды задержек. Информации много не бывает при поиске причин неисправностей. Вот среднее квадратичное мы хотя и могли бы ввести, но пока не знаем, как его правильно применить. Поэтому полагаем излишним. А вот минимальное, среднее арифметическое и максимальное — это основа статистики, они нам пригодятся в любом случае. Ну и дискуссия о «нормальных» значениях тоже будет.
Ну и в финале определения первичных метрик не откажем себе в удовольствии устроить заочную полемику с отраслевым стандартом Y.1540. Ему многие поклоняются, как божеству, но писали его люди, они склонны ошибаться, а на ошибках надо учиться, а не поклоняться им без страха и упрёка. Итак, IPER или Internet Protocol packet Error Ratio. Кто‑то решил, что будет полезно измерять процент IP‑пакетов, доставленных с ошибкой. Не отрицая, что на каналах связи ошибки встречаются (см. выше в разделе 1.1), более того, подчёркивая, что эти события на некоторых физических средах являются более‑менее естественным явлением, мы тем не менее всегда помним, что эксплуатируем‑то мы всю сеть, как единое целое. А на сети TCP/IP ошибки купируются после приёма на коммутатор или маршрутизатор и дальше в исходящий интерфейс или в процесс, открывший сокет, не передаются! Странно, что вроде бы грамотные люди, писавшие Y.1540, не увидели очевидного: За пределами одного канала измерять процент ошибочно доставленных IP‑пакетов не имеет смысла! Ошибки по сети TCP/IP не транслируются в отличие от сетей с коммутацией каналов. Поэтому даже если на измерительном устройстве вы подмените своим приложением стек TCP/IP и доведёте ошибку в пакете до подпрограммы, способной увеличить счётчик на один, вы получите только ошибки «последнего дюйма». Это точно то, что вы ожидали? Жизненный опыт связистов подсказывает, что нет.
Именно по этой причине, хотя и зная, что ошибки на каналах есть, мы тем не менее вводить метрику, аналогичную Y.1540 IPER, не будем, считая этот увлекательный процесс стрельбой из единорогов Шувалова по воробьям.
Раздел 1.7. Дополнительные метрики
Основная масса пользователей и даже многие связисты, прочитав предыдущий раздел, полагают, что можно успокоиться. Метрики введены, инструменты, их показывающие, известны, можно «давить на массу». Но мы всё-таки пойдём дальше. Так как собственный опыт, сын ошибок трудных, говорит о том, что лучше всё-таки попробовать объять необъятное, чем остановиться в развитии. Ибо «кто хочет — ищет способ, кто не хочет — ищет причину». Сказано давно, не нами и не нам исправлять.
Начнём с малого:
Определение 31
число пакетов теста, успешно принятых на стороне приёма за время T[r], однако доставленных с изменением порядка следования.
Определение 32
процент пакетов в тесте, доставленных с изменением порядка следования (процент нарушения очерёдности).
Очень хорошо данная метрика может быть показана на рисунке!
Рисунок 7. Сеть связи, на которой производится изменение порядка следования.
где
Пакеты пользовательского трафика, направленные от CE1 до CE2.
Канальное оборудование на сети оператора связи, в котором производится изменение порядка следования пакетов.
Событие переставляющее жёлтый пакет со своего места.
Доставка пользовательских пакетов без дальнейших изменений порядка.
Посмотрим внимательно на рисунок 7, зафиксируем, что N[ro] равно 1, а N[r] равно 4, и получим OR[r] равным 25%. Теперь обговорим подробности.
Средняя программа, использующая стек TCP/IP, как это не покажется удивительным, обычно ожидает, что первый пакет придёт первым, второй — вторым, и так далее. Бывает иначе, но это редкость. Ну и в самом деле, если вы говорите в трубку: «Алё, привет, ты где?», то ожидаете, что собеседник услышит это в нужном порядке. Так же и в программах. Но когда пакет ушёл в сеть, он уже не имеет информации ни о своём номере, ни о номере соседа. Умные транзитные P‑устройства стараются более‑менее сохранять порядок, например, используя так называемую технологию flow switching. Но, вообще говоря, делать этого не обязаны. Не будем далеко погружаться в тему, она любопытна, но не в разделе определений. Скажем здесь, что отслеживание процента нарушения очерёдности на ядре сети является на наш взгляд хорошим тоном правильного, кошерного оператора связи. Поэтому нормальным значением OR[r] является 0%.
Теперь более нетривиальное:
Определение 33
число пакетов теста, успешно принятых на стороне приёма за время T[r], доставленных с минимально возможным полем TTL (Hop Limit).
Определение 34
процент пакетов в тесте, доставленных со значительным сдвигом в пути следования (процент сдвига пути).
Здесь вообще без иллюстрации будет трудно. А мы стремимся быть понятыми.
Рисунок 8. Сеть связи, на которой производится изменение путей следования.
где
Пакеты пользовательского трафика, направленные от CE1 до CE2.
Канальное оборудование на сети оператора связи, в котором производится изменение путей следования пакетов.
Доставка красного и зелёного пакетов по пути с одним транзитом.
Доставка жёлтого и коричневого пакетов по пути с двумя транзитами.
«Это что такое? И зачем?» - спросит наш уважаемый читатель. Немного предыстории. Один наш хороший друг работал в одном большом операторе связи. В середине сеть была построена почти так же, как автоматическая камера хранения на вокзале современного Кёльна: вы видите только терминал для приёма и передачи, а куда и как поехал ваш чемодан является тайной, покрытой мраком. Роботизация настигла их сети по программе‑максимум. В результате одинокий traceroute, проводимый в целях диагностики пути следования пакетов, сегодня ходил в Тацинскую, завтра в Сарепту, а послезавтра в Шексну. Это чертовски усложняло поиск неисправностей в ядре. Потому что производитель роботизированного оборудования, как несложно догадаться, в первую очередь думал о пропуске трафика, ну и об активных продажах, как же без этого, а вот про диагностику подумал только «опосля», как сказал бы наш хороший друг. В результате только так называемый «метод» полного перебора каждого из портов приводил к нахождению проблемного порта или канала. Требовалась некоторая автоматизация.
Мы подумали, что при прохождении трафика по ядру, если у вас не установлен TTL propagation, можно вычислить сколько пакетов в тесте прошло большее количество транзитных устройств, чем могло бы. Разумеется, при равенстве точек, пусть даже и разных, такую информацию не получить. Но при развитой сети вполне возможна ситуация, когда дешевле и быстрее пропустить трафик через два‑три транзита, чем через один, но уже перегруженный канал. На это и строится расчёт.
Метрика новая, ещё нигде не стандартизированная, но уже опробованная. На наш скромный взгляд, она достойна пристального внимания. Возможно, мы немного самонадеянны, но нам пока так не кажется. Широкое распространение SDN может породить высокий интерес к этому нашему изобретению. К дискуссии же мы всегда готовы. Ну и нельзя не отметить, что на рисунке 8 значение N[rl] получается 2, значение N[r] равно 4, соответственно SR[r] получается 50%. Нормальным же значением мы полагаем 0%.
А вот вновь относительно простое и ясное понятие:
Определение 35
процент потерянной полосы пропускания при приёме теста (потерянная скорость).
Здесь иллюстрация та же, что и на рисунке 5, поэтому перейдём сразу к объяснениям.
Скорость можно измерять по‑разному. Можно в битах в секунду, можно в процентах от ожидаемой. А можно, как здесь — в процентах от так называемой «потерянной». Если обычная скорость чем больше, чем лучше и, заметим, дороже, то в этой метрике всё наоборот. Чем выше процент — тем хуже. А когда потерянная скорость достигает 95%, можно сказать, что оператора пора менять. Вы ведь не из такого оператора, правда?
Зачем это выворачивание наизнанку? Секрет прост — в системах мониторинга, за которые в итоге мы ратуем, может быть разный подход к фиксации проблем. Кто-то использует неравенства вида N[r]>100 и раскраску «плохо» и «хорошо». Это хотя и просто, но не позволяет видеть гибкой градации. А кто-то использует набор порогов для «зелёных», «жёлтых», «красных» и «ужасных» событий, а к ним простое правило — чем больше параметр, тем хуже. Потери, задержки, процент перекраски, процент сдвига и процент беспорядка — всё растёт. Иногда — как на дрожжах. И только скорость стоит особняком. Чем она меньше, тем хуже и хуже, а когда она становится равной 2400 бит/с, можно начинать искать на антресолях старенький USR Courier и вспоминать, как правильно настраивается Bink/+ и BiP. Поэтому заведение потерянной скорости как хотя и наведённой, но разумной метрики, весьма душеспасительно при дальнейшем внедрении систем мониторинга. Так как она тоже, чем больше тем хуже. Это даёт нужную гибкость и в то же время не ограничивает от простых решений.
И последнее. Метрики, про которые многие слышали, и даже министерство, вслед за международными организациями, пытается их нормировать, но пока ещё на реальных, а не лабораторных сетях — не в коня корм. Дрожание. Обло, озорно, огромно, стозевно и лаяй. Все знают, никто не понимает. Итак:
Определение 36
дрожание задержки доставки пакетов от стороны генератора до стороны назначения, измеренное за время T[r] по алгоритму RFC-3550.
Определение 37
минимальное ненулевое дрожание задержки доставки пакетов от стороны генератора до стороны приёма, измеренное за время T[r] по алгоритму Y.1540 с использованием в качестве базиса минимальной задержки.
Определение 38
максимальное дрожание задержки доставки пакетов от стороны генератора до стороны приёма, измеренное за время T[r] по алгоритму Y.1540 с использованием в качестве базиса минимальной задержки.
Определение 39
среднее арифметическое дрожания задержки доставки пакетов от стороны генератора до стороны приёма, измеренное за время T[r] по алгоритму Y.1540 с использованием в качестве базиса минимальной задержки.
Определение 40
минимальное дрожание задержки доставки пакетов от стороны генератора до стороны приёма, измеренное за время T[r] по алгоритму G.1020.
Определение 41
максимальное дрожание задержки доставки пакетов от стороны генератора до стороны приёма, измеренное за время T[r] по алгоритму G.1020.
Определение 42
среднее арифметическое дрожания задержки доставки пакетов от стороны генератора до стороны приёма, измеренное за время T[r] по алгоритму G.1020.
Что нам тут хочется сказать? Пока не будем растекаться мысью по древу. Любопытные подробности будут позже. Пройдёмся и по алгоритмам расчёта дрожания и по их авторам. Где-то паровым катком, а где-то — просто пожав плечами. Не волнуйтесь, всё будет. Пока примите как данность, потому что пора следовать дальше. Нас ждут трудности. А мы их и не боимся.
Раздел 1.8. Определения протоколов тестирования
Внимательный читатель, конечно же, уже отметил, что все приведённые метрики приведены только для случая создания трафика на одной стороне и приёма его на другой. «А как же быть с эксплуатацией?» — задаст он вопрос — «Ведь трафик‑то в реальной сети всегда двунаправлен?». Верно, ответим мы, для лучшего понимания мы специально разделили метрики на две части и объединим их под конец главы.
В целях лучшего понимания, коль скоро наш читатель информирован и внимателен, сперва обсудим: а в соответствии с какими, собственно, протоколами генерировать искусственный трафик? Иначе говоря, какие программы использовать для создания потока? Обычно стандарты слабо конкретизируют этот важный вопрос и здесь, безусловно, есть некоторая степень произвола выбора со стороны системных администраторов. От идеального протокола хотелось бы получения максимального числа возможных метрик за один пропуск теста. В то же время это идеал, и все мы за ним гонимся, но если уже есть готовые программы, как широко известный среди любителей сетевых игр ping, глупо их не использовать. Пусть даже мы и получим только некоторые метрики.
При этом важно понимать, что как настройки поведения генератора в разделе 1.4, настройки поведения стороны назначения в разделе 1.5, так и все метрики, измеряемые сторонами, необходимо каким-то образом передать между устройствами измерения. Эти важные вопросы мы обсудим позже, не волнуйтесь, а пока неявно предполагаем, что настройки волшебным образом переданы, допустим паном Кляксой, и сосредоточимся именно на протоколах измерения.
Нам потребуются следующие определения:
Определение 43
Однонаправленный протокол (OP) - Набор правил и действий, создающий тест, который передаётся генератором и получается стороной приёма. На стороне генератора трафик описывается параметрами:
P[s], O[s], N[s], B[s], C[s].
Сторона приёма использует алгоритм 1 для вычисления тех метрик, которые могут быть рассчитаны конкретной реализацией.
Заметим, что расчёт всех метрик в общем случае может и не случиться, поэтому в определении мы и не вводим эту необходимость. Очень многое зависит от реализации программ как генератора, так и приёмника.
Определение 44
Двунаправленный протокол с зависимым генератором на стороне приёма (TP) - Набор правил и действий, создающий тест, который передаётся генератором, получается стороной приёма, возможно, модифицируется ею и возвращается к генератору. На стороне генератора трафик описывается параметрами:
P[s], O[s], N[s], B[s], C[s].
Сторона приёма использует алгоритм 1 для вычисления тех метрик, которые могут быть рассчитаны конкретной реализацией.
Для собственной генерации сторона приёма использует параметры
P[s], O[s].
По возможности ею используются параметры N[s], C[s].
Под определение 44 попадают те протоколы, где явно разделены стороны генератора и так называемого ответчика (по-английски responder), позволяющие с одной стороны сэкономить на оборудовании, с другой — получить хотя бы некоторые метрики о состоянии сети.
Определение 45
Двунаправленный протокол с независимым генератором на стороне приёма (TNP) - Набор правил и действий, создающий два теста, один из которых передаётся генератором, получается стороной приёма, а другой передаётся стороной приёма и получается генератором. На стороне генератора трафик описывается параметрами:
P[s], O[s], N[s], B[s], C[s].
Сторона приёма использует алгоритм 1 для вычисления тех метрик, которые могут быть рассчитаны конкретной реализацией.
На стороне приёма генерируемый трафик описывается параметрами:
P[s], O[s], N[s], B[s], C[s].
Генератор использует алгоритм 1 для вычисления тех метрик, которые могут быть рассчитаны конкретной реализацией.
Под определение 45 попадают те протоколы, где стороны генератора и приёмника равноправны и создают трафик либо одновременно, либо псевдоодновременно, но так чтобы в результате получалось полнодуплексное тестирование, близкое к реальному пользовательскому трафику.
Для случая двунаправленного протокола, имеющего асимметрию по скорости генерации, введём определение:
Определение 46
скорость генерации теста на стороне приёма.
Определение 47
Двунаправленный протокол с асимметричным независимым генератором на стороне приёма (TAP) - Набор правил и действий, создающий два теста, один из которых передаётся генератором, получается стороной приёма, а другой передаётся стороной приёма и получается генератором. На стороне генератора трафик описывается параметрами:
P[s], O[s], N[s], B[s], C[s].
Сторона приёма использует алгоритм 1 для вычисления тех метрик, которые могут быть рассчитаны конкретной реализацией.
На стороне приёма генерируемый трафик описывается параметрами:
P[s], O[s], N[s], B[r], C[s].
Генератор использует алгоритм 1 для вычисления тех метрик, которые могут быть рассчитаны конкретной реализацией.
Под определение 47 попадают те протоколы, где стороны генератора и приёмника равноправны, создают трафик либо одновременно, либо псевдоодновременно, при этом с разной скоростью генерации. В результате получается полнодуплексное тестирование, близкое к пользовательскому трафику, который использует асимметричное включение в сеть, например ADSL.
Конкретные реализации (включая, конечно же, знаменитый среди широких кругов пользователей сети ping) мы рассмотрим позже. А пока вновь займёмся определениями, на этот раз уже для двунаправленного трафика.
Раздел 1.9. Двунаправленные метрики
Поскольку при полнодуплексном трафике теста итоговые метрики зависят от типа применяемого протокола и от его фактической реализации, мы будем вводить в определения данного раздела некоторые уточнения. В отличие от отраслевых стандартов, где этот важный вопрос пущен на самотёк, мы постараемся быть научно корректными.
Вначале понятия о времени:
Определение 48
абсолютное время начала отправки пакета с номером i от стороны приёма.
Определение 49
абсолютное время окончания приёма пакета с номером i на стороне генератора.
«О ужас! Вновь страшные математические сложности!» — слышим мы. Не согласны. Всё просто. Вспомним, что в зависимом генераторе на стороне приёма совсем не обязан быть фиксатор числа принятых пакетов. Ведь программное обеспечение может просто реализовать эхо‑протокол. Кто сказал ping? Да, там именно так всё и сделано. Поэтому и приходится уточнять определения с тем, чтобы они были универсальны.
Теперь вновь сладкая парочка, только для стороны начала сессии:
Определение 50
число пакетов теста, успешно принятых на стороне генератора за время T[p].
Определение 51
период времени приёма теста на стороне генератора.
«Да как же так! Вы же только что сами писали, что N[r] может существовать, а может и нет. А в последнем определении про это уже забыли?» — скажет наш любимый читатель. Нет, не забыли. Мы помним о поведении стороны приёма. Но тут, как в известном анекдоте, есть нюанс: дело в том, что на приёме генератор ожидает прихода не N[r] пакетов, ему эта информация станет видна только в процессе теста, причём чаще всего по итогам. Если реализация вообще это поддерживает, к слову говоря. А ждёт он N[s] пакетов, то есть такого же числа, как он и передал, а точнее всё ещё передаёт.
Вот теперь и можно начинать определять сами метрики для двунаправленного трафика. Потери:
Определение 52
процент потерянных пакетов в тесте на стороне генератора за время T[p].
Несложно видеть, что при существовании на стороне приёма N[r] потери от стороны генератора до стороны приёма описываются уже введённым в разделе 1.6 LR[r], а обратные потери — LR[p]. В случае же отсутствия на стороне приёма N[r] потери по каждому отдельному направлению невозможно определить, а вот круговые потери от генератора до приёма и обратно описываются LR[p]. Иллюстрировать поведение сети здесь будет излишним, так как рисунок 3 всего лишь зеркалится.
Теперь перекраска:
Определение 53
число пакетов теста, успешно принятых на стороне генератора за время T[p], однако доставленных с классом сервиса, отличным от C[s].
Определение 54
процент пакетов в тесте, доставленных с изменённым классом сервиса от приёма до генератора (процент перекраски).
Здесь всё проще, поскольку процент считается не от общего числа переданных пакетов, а только от доставленных. Как и в случае с потерями, при существовании на стороне приёма N[rr] перекраска от стороны генератора до стороны приёма описывается уже введённым в разделе 1.6 RR[r], а обратная перекраска — RR[p]. Если же N[rr] отсутствует на стороне приёма, то RR[p] описывает круговую перекраску трафика без выделения направления.
Переходим к скорости:
Определение 55
измеренная скорость среди успешно принятых пакетов на стороне генератора за время T[p].
Что является важным для измеренной на стороне генератора скорости? Ведь с первого взгляда это весьма простая метрика, понятная даже младенцу. Мы, правда, за всю свою практику ещё не видели младенца, проверяющего сети TCP/IP, так что это всего лишь одна из тех гипербол, которыми славятся связисты в реальной, недостаточно документированной жизни. Но всё-таки, рядовой пользователь сети, пусть и возрастом давно не младенец, понимает это в полсекунды. Все те ограничения, про которые мы говорил в разделе 1.6 о метрике BW[r] применимы, конечно, и к BW[p]. Но есть и новое: измеренная скорость весьма зависима от вида применяемого протокола. В случае, когда для проверки мы используем протокол TP, есть существенная особенность. А именно:
Причём, отметим, что именно за счёт выбора протокола с зависимым генератором на стороне приёма, мы не можем получить скорость передачи от него в сторону инициатора, большую, чем ту, на которой он сам получил трафик.
Представьте, что ваш любимый ping шлёт пакеты достаточно быстро (такие реализации есть, мы же общаемся с опытными специалистами, не забыли?) и развивает скорость передачи B[s], нужную вам, однако, вот загвоздка, от генератора к стороне приёма есть 1% потерь пакетов, такая досталась нам сеть. Каким получится в итоге результат на приёме? Правильно, близким к формуле BW[r] = 0,99 × B[s]. И отправить трафик обратно сторона, которую так сказать «пингуют», никак не сможет быстрее, чем BW[r], даже если приёмник вывернется наизнанку. У него же нет информации о B[s], ведь он зависим! А теперь представим, что от приёмника до генератора тоже есть потери, к примеру 2%. Релейка глючит, птицы перелётные пошли на взлёт. Что получится в измеренной скорости на стороне инициатора? Верно, значение близкое к формуле BW[p] = 0,98 × BW[r] = 0,9702 × B[s]. Прилагательным «близкий» мы тут формулируем ту неопределённость, которая характерна для всех статистических величин, так как в реальной сети могут быть, разумеется, отличия.
Из указанного неравенства, особенно после нашего несложного примера, становится очевидно, что проверять реальную пропускную способность сети использованием метрики BW[p] при использовании протокола TP можно, когда нет иного выхода. И полученное числовое значение можно считать корректным условно. Точные ограничения мы пока опустим, здесь важен сам факт.
А вот в случае использования протоколов TNP или TAP, всё становится более корректным. Так как они независимо создают поток от стороны приёма, что позволяет использовать BW[p] уже всерьёз.
Простой параметр, правда? Вот так начнёшь изучать фамильные портреты и, пожалуй, уверуешь, что ты знаешь лишь то, что ничего не знаешь, впрочем, другие не знают и этого. Мы сами не стесняемся учиться и вам рекомендуем не забывать ни латыни, ни древнегреческого.
Вот так, невидимыми семимильными шагами мы вернулись к задержкам, только на этот раз в другую сторону.
Определение 56
минимальная задержка успешной доставки пакетов от стороны приёма до стороны генератора, измеренная за время T[p].
Определение 57
максимальная задержка успешной доставки пакетов от стороны приёма до стороны генератора, измеренная за время T[p].
Определение 58
среднее арифметическое задержек успешной доставки пакетов от стороны приёма до стороны генератора, измеренных за время T[p].
Про задержки в целом всё было сказано в прошлый раз, здесь мы только отметим, что если в протоколах TP нет поддержки T3[i], то данные метрики измерить не представляется возможным. Этой особенностью, например, обладают все эхо‑протоколы, как ICMP, так и UDP. Ну и не забудем именно здесь отметить, что для корректного расчёта как mD[p], MD[p], AD[p], так и mD[r], MD[r], AD[r] обе стороны должны быть синхронизированы по времени. Вопросы точности синхронизации — отдельная интересная проблема, здесь мы её пока отложим.
Что же делать, если задержки хочется получать, а синхронизации нет и не предвидится? Вспомнив Платона «Хорошее начало — половина дела», мы обнаружим, что на помощь приходит наш старинный добрый друг:
Определение 59
минимальная круговая задержка измеренная за время T[p].
Определение 60
максимальная круговая задержка, измеренная за время T[p].
Определение 61
среднее арифметическое круговых задержек, измеренных за время T[p].
Неожиданно сложные определения, скажете? «Мы не смеем не потому, что задача трудна. Это задача трудна, оттого что мы не смеем» - так говорили в античности, вот и возьмём на вооружение.
Опустим вырожденные случаи, когда принятых пакетов нет. Понятно, что в этом случае будут нулевые метрики. Займёмся вторыми и третьими случаями. Во вторых мы видим суммирование двух односторонних задержек от генератора к приёмнику (T2[i] - T1[i]) и от приёмника к генератору(T4[i] - T3[i]) (см. выше определения mD[p], MD[p], AD[p], mD[r], MD[r], AD[r]). Затем проводятся либо выборки минимального или максимального, либо дальнейшее суммирование для получения среднего арифметического. Сложность уменьшилась, всё ясно. Теперь разбираемся, зачем написаны условия справа. Всё дело в том, что при использовании протокола TP приёмник совсем не обязан реализовывать работу с метками T3[i] и T2[i], например, если он работает как простое эхо, то этих меток просто нет. Поэтому нужен третий случай, который описывает круговые задержки в случае отсутствия в реализации меток T3[i] и T2[i]. Хорошо было бы конечно, выбрасывать время обработки пакета на приёмнике всегда, чтобы получать более корректные значения круговых задержек, но коль скоро реализация не поддерживает, лучше получить хотя бы неточное значение, чем вовсе ничего. Именно про это третий случай.
Ну и в финале заметим, что для расчёта круговых задержек синхронизация времени между генератором и приёмником не нужна. Оставим нашим дорогим читателям доказательство этого несложного факта в качестве домашнего задания. А сами же отметим, что в крайнем случае, когда генератор и приёмник умеют мало, а хочется всё‑таки получить односторонние задержки, вы можете просто разделить круговую задержку на два, поскольку это лучше, чем ничего. Не верите? Проверьте на досуге, если он у вас есть, как происходит синхронизация времени в широко известных программных пакетах ntpd и ptpd и удивитесь повторно. Мы в процессе своей профессиональной деятельности наблюдали, как большое число коллег из нашей важной отрасли копируют из устройство в устройство настройки синхронизации, но даже не задумываются, почему у одного из широко известных производителей в документации написана фраза «...assumes a NTP accuracy that is 10% of the latency between the end point», хотя вообще-то это достаточно важно. Впрочем, об этом мы ещё напишем.
Раздел 1.10. Двунаправленные дополнительные метрики
Аналогично описанию метрик из раздела 1.7, мы начнём с порядка следования:
Определение 62
число пакетов теста, успешно принятых на стороне генератора за время T[p], однако доставленных с изменением порядка следования.
Определение 63
процент пакетов в тесте, доставленных к генератору с изменением порядка следования (процент нарушения очерёдности).
Как и в случае с перекрашенным трафиком, процент здесь считается не от общего числа переданных пакетов, а только от доставленных, чтобы купировать потери. При существовании на стороне приёма N[ro] нарушение порядка от стороны генератора до стороны приёма описывается уже введённым в разделе 1.7 OR[r], а обратное — OR[p]. Если же N[ro] отсутствует на стороне приёма, то OR[p] описывает круговое нарушение порядка без выделения направления.
Ну и не забываем определить наше новое изобретение:
Определение 64
число пакетов теста, успешно принятых на стороне генератора за время T[p], доставленных с минимально возможным полем TTL (Hop Limit).
Определение 65
процент пакетов в тесте, доставленных к генератору со значительным сдвигом в пути следования (процент сдвига пути).
Важно отметить, что в связи с особенностями стека TCP/IP, метрика SR[p] будет всегда описывать трафик от приёмника к генератору! Здесь информация о прохождении трафика от генератора к приёмнику в случае использования протоколов без поддержки N[rl] будет утрачена сразу после приёма. Увы! Поэтому, если процент сдвига пути важен, следует использовать правильное программное обеспечение.
Не забываем о проценте потерянной скорости:
Определение 66
процент потерянной полосы пропускания при приёме теста на стороне генератора (потерянная скорость).
В последнем определении нет ничего сложного, несмотря на кажущуюся громоздкость. Несколько вариантов указаны в связи с тем, что при использовании протокола TAP в качестве ста процентов скорости используется не B[s], а B[r]. Поэтому и появляются дополнительные варианты по сравнению с определением в разделе 1.7. Всё же остальное, сказанное про LBW[r] относится и к LBW[p].
Не будем забывать, что при использовании протокола TP скорость генерации будет зависеть от скорости приёма (см. комментарии к определению 55), поэтому LBW[p] следует использовать в этом случае с аккуратностью, ниже мы поговорим об этом подробнее.
Ну и дрожание у задержек доставки трафика от стороны приёма до стороны генератора тоже случается, поэтому слегка модифицируем уже известные определения.
Определение 67
дрожание задержки доставки пакетов от стороны приёма до стороны генератора, измеренное за время T[p] по алгоритму RFC-3550.
Определение 68
минимальное ненулевое дрожание задержки доставки пакетов от стороны приёма до стороны генератора, измеренное за время T[p] по алгоритму Y.1540 с использованием в качестве базиса минимальной задержки.
Определение 69
максимальное дрожание задержки доставки пакетов от стороны приёма до стороны генератора, измеренное за время T[p] по алгоритму Y.1540 с использованием в качестве базиса минимальной задержки.
Определение 70
среднее арифметическое дрожания задержки доставки пакетов от стороны приёма до стороны генератора, измеренное за время T[p] по алгоритму Y.1540 с использованием в качестве базиса минимальной задержки.
Определение 71
минимальное дрожание задержки доставки пакетов от стороны приёма до стороны генератора, измеренное за время T[p] по алгоритму G.1020.
Определение 72
максимальное дрожание задержки доставки пакетов от стороны приёма до стороны генератора, измеренное за время T[p] по алгоритму G.1020.
Определение 73
среднее арифметическое дрожания задержки доставки пакетов от стороны приёма до стороны генератора, измеренное за время T[p] по алгоритму G.1020.
В случае использования протоколов TP, все виды дрожания на приёме у генератора будут описывать круговое дрожание, а не одностороннее. Сомневаетесь? Проверьте поведение зависимого генератора и убедитесь в этом сами. Умный читатель уже говорит нам, что у одного калифорнийского производителя сетевого оборудования написано иначе, и что дескать их широко известный в узких кругах responder это учитывает? «Ну-ну» - скажем мы. Включите отладку в оборудовании (естественно, в лаборатории, а не на реальной сети!) и убедитесь в том, что мы вначале думаем, потом разрабатываем свою гипотезу, строим теорию, обкатываем её на практике, а только потом выдаём итоговые рекомендации, как и положено у научно мыслящих людей. И никак иначе!
Ну что, коллеги?! Кажется с определениями метрик покончено и можно начинать более пристально заниматься описанием самих технологий тестирования. Остаётся только напомнить, что все описанные метрики являются статистическими величинами. И для них не может быть создан эталон! Важно понимать, что на сетях TCP/IP любое достаточно производительное устройство с операционной системой общего типа пригодно как для генератора, так и для приёмника. Неважно, есть ли на устройстве голографическая метка, полученная от государственных органов или нет, так как в статистике мы оперируем не физическими величинами, а результатами наблюдений.
Раздел 2.1. Первая попытка установки агентов
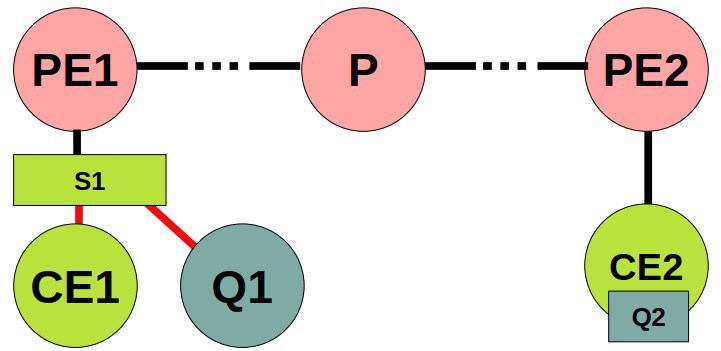
Прежде чем решить, как правильно тестировать сети TCP/IP в целях получения метрик, введём парочку определений для применения в дальнейших схемах.
Определение 74
Q1 - точка создания теста (оборудование или программный процесс). Агент-инициатор.
Определение 75
Q2 - точка назначения теста (оборудование или программный процесс). Сопряжённый агент.
Сразу заметим, что последние определения намеренно введены без конкретизации аппаратной или программной платформой создаётся тест. Так как стандарты в этом вопросе до сих пор, несмотря на многие прошедшие лета от рождества Сети, скажем мягко «плавают», говоря о «необходимости дальнейших исследований». Вот, например, что пишет международный отраслевой стандарт Y.1540: The exact location of the IP service MP within the IP protocol stack is for further study. Оставим без перевода эту прекрасную фразу, которая у служб эксплуатации может вызвать разве что гомерический хохот. Поневоле вспомнишь известный анекдот про результаты вопроса в сети FIDOnet: ответ получен абсолютно верный, абсолютно бесполезный, и не содержащий ничего, чего вопрошающий не знал бы и сам.
Мы же, исходя из насущной необходимости работать здесь и сейчас, не будем теоретизировать, а попробуем решить за международное телеком-сообщество, где именно и как следует ставить собирающие статистику устройства.
И начнём с того, что просится первым на ум.
Рисунок 9. Включение агентов в разрыв каналов связи.
где
Оборудование, создающее или получающее тест
Всё вроде бы на своём месте. Логично же, да? Устанавливаем нужные дополнительные устройства прямо в разрыв канала. Видим весь трафик. Можем делать с ним всё, что захотим. Можем даже посчитать для всех пакетов все статистические величины и по ним сделать выводы о качестве услуг на самой сети. Более того, уже не раз всуе упомянутый Y.1540 тоже содержит внутри себя очень-очень похожую схему. Но! Один известный математик и философ говорил «De omnibus dubitandum». И этот девиз на наш скромный взгляд следовало бы каждому связисту взять на вооружение.
Итак, сомнения.
1. Всякое устройство в сети создаёт точку отказа. Лишнее устройство — лишняя точка отказа. Включение чего-то не слишком нужного в разрыв существующего канала связи — это «смертный грех» для любого связиста, даже если он неверующий. Можно, конечно, сделать проключение канала на случай пропадания питания. Такие технологии есть, хотя мы лично смотрим на них скептически. Но если вышел из строя процессор или память Q-агента? Питание есть, а канала нет? Не слишком ли большие жертвы для сети ради измерений?
2. Всякое устройство имеет пределы производительности. Поэтому при росте трафика и планируемой замене придётся менять и измерительные агенты на нужные по производительности. А если мы их используем не на полную мощность в реальности? Ведь тестовый трафик не обязан быть объёмным для получения метрик! Но необходимость сохранения транзитного трафика на нужной скорости продиктует нам необходимость замены.
3. Производитель всякого устройства для сети связи стремится сесть оператору на шею. Умными английскими словами это называется vendor lock. «Ничего личного, это просто бизнес», слышали эту фразу? А производители дополнительных устройств, дающих сети вкусности и пряности, разумеется, совсем не горят желанием свой труд стандартизировать между собой. Даже наоборот, стремятся патентовать, скажем, забегая вперёд. А теперь ответьте себе на простой вопрос: «Хочу ли я получить в качестве хотя и важной, но всё-таки не главной особенности на сети постоянного кандидата на роль Лисы из сказки «Битый небитого везёт?»
4. Ну и наконец. Сеть занимается в первую очередь пропуском пользовательского трафика и получением прибыли от этого. Всякое дополнительное устройство — суть расходный бюджет. Его следует минимизировать, а в этой схеме будет только рост. Ведь не на каждый порт нужно ставить такие устройства! Схема подключения должна быть разумной, позволяющей выбрать нужный компромисс. В приведённой же на рисунке 9 такого компромисса нет, схема как бы подталкивает нас поставить агенты везде, здесь мы видим пример принципа «Всё или ничего», что для практикующего Связиста — второй «смертный грех».
Так что, как бы не хотелось нам простых решений, придётся искать не простые, а правильные. Тем же производителям, которые остановились на простых схемах мы скажем на манер древнего грека: «Движение — это жизнь, а жизнь — это движение, не останавливайтесь на достигнутом».
Раздел 2.2. Правильное включение дополнительных устройств
Предисловия закончились, и мы приводим первую рабочую схему, широко применяемую у реальных операторов связи, с кучей достоинств и почти без недостатков.
Рисунок 10. Включение агентов T-образно без разрыва каналов связи.
где
Оконечное оборудование канала связи, допускающее дополнительное включение помимо одного пользовательского. В случае использования каналов связи типа Ethernet, это коммутатор.
Последняя часть канала связи, соединяющего клиентское оборудование и операторское. Так называемый «последний дюйм». В случае использования каналов связи типа Ethernet, это патч-корды.
Внимательный читатель уже понял, куда мы клоним. В настоящее время в подавляющем числе подключаемых устройств используется стандарт Ethernet. Фактически стали редкостью иные решения. Поэтому коммутатор, позволяющий включить более одного порта клиенту уже не только норма, но часто встроен в устройство по умолчанию. Глупо не использовать открывшуюся возможность.
Теперь вновь рассмотрим сомнения из раздела 2.1.
1. Есть ли в новой схеме дополнительная точка отказа? На первый взгляд есть, конечно, это коммутатор! Но во-первых, если он встроен в CE, точки отказа уже не будет. Во-вторых, на сегодняшний момент коммутаторы стали штатными устройствами сети, выходящими из строя, как правило, только по питанию, что упрощает замену. Это хотя и слабое, но утешение. В-третьих, часто на площадке клиента уже предусмотрен коммутатор, и в этом случае дополнительная точка отказа отсутствует. Это уже существенный прогресс по сравнению с рисунком 9.
2. Производительность агента теперь никак не зависит от производительности канального оборудования. Можно и даже нужно использовать ровно такие агенты, какие необходимы. Можно смело менять коммутаторы и CE на более производительные, если уже установленных агентов для проверки сети более чем достаточно. Гибкость налицо.
3. При установке по такой схеме можно смело использовать агенты разных производителей. Разумеется, если они совместимы по используемым протоколам. Мы не только не привязаны к производителю, мы можем делать перестановки на сети так, как это наиболее рационально в процессе эксплуатации, не ожидая благословления от сторонних организаций. Ещё плюс в копилку.
4. И наконец, мы можем планировать бюджет ровно так, как необходимо. T-образное включение не заставляет нас ставить агенты везде, оно нам прямо рекомендует ставить их только там, где необходимо. И даже больше — можно даже вовсе не ставить дополнительных агентов! И именно этот вопрос мы рассмотрим в следующем разделе.
Раздел 2.3. Правильное использование существующих устройств
Хорошо образованный связист всегда жаждет объединить отдельно стоящие устройства в единое целое. Это его органическое свойство, можно даже сказать неотъемлемая черта. И это прекрасно, так как и телеграфные, и телефонные сети, и нынешний интернет появились именно благодаря такому желанию. «Разумно устроенный связист несёт миру прогресс», - так сказали бы уже не древние философы, умудрённые гимнастикой ума, а мы, простые российские связисты.
Поэтому у просвещённого читателя, как мы надеемся, уже у самого появилась назойливая, как жужжащая муха, мысль об объединении CE и Q-агентов во что-то общее. Не будем забывать, что большинство CE устроены как компьютеры общего назначения из раздела 1.2. Следовательно, нужно просто поставить производителю задачу реализовать тот или иной протокол в его устройстве, и мы получим и экономию, и меньшее количество проводов, и повышение надёжности. А, кроме того, возможно производитель уже что-то такое реализовал сам! Ведь ping-то в разделе 1.8 упоминался, значит авторы в курсе простых решений! Ну и более сложные, конечно, пусть даже и привязанные не к стандарту, а к патенту.
Читатель полностью прав, поэтому без лишних слов приводим схему, в которой само CE-устройство поддерживает нужные возможности.
Рисунок 11. Использование пользовательского оборудования как агентов.
где
Пользовательское оборудование, поддерживающее в своём ПО один из протоколов OP, TP, TNP, TAP.
Ну отлично же! Агент встроен в устройство, все проблемы решены. И всё-таки пройдём по пунктам сомнений бодрым шагом.
1. Есть ли в новой схеме дополнительная точка отказа? Всё отлично, ведь поменялось только ПО. Рассуждения, что агент может быть с ошибками и вести к краху всего устройства, конечно, допустимы. Авторы видели такое в своей практической работе. Однако, это редчайшие случаи, которыми можно пренебречь. Хотя лабораторный «обкат» устройств необходим, но вы ведь всё равно его проводите до внедрения, так ведь? Так что плюсы.
2. Что касается связанной производительности, то тут, очевидно, всё зависит от CE-устройства. Насколько оно само производительно, настолько производителен и встроенный агент. Есть и нетривиальные особенности, так как агент встроен в ПО, поэтому всё зависит от реализации. Если операционная система и более высокоуровневое ПО недостаточно «реактивны», то может так получиться, что агент вынужденно будет использовать неполный ресурс. Так может себя вести, например, коммутатор, у которого основная логика передачи пакетов на канальном уровне вынесена на аппаратные схемы с нужной скоростью, а ПО предназначено для обслуживания. При добавлении агента в такой коммутатор, мы вынуждено получим низкую производительность. Бывает и наоборот. Агент на устройствах, где честный арбитраж между процессами пущен на самотёк, может исчерпать все ресурсы CE-устройства, вообще-то в первую очередь предназначенную для пропуска трафика. Так может быть, например, на плохо сконфигурированных Linux/BSD-box. По итогам можно сказать, что при относительно слабой нагрузке от агента на CE, проблема связанной производительности практически решена.
3. Лёгкость миграции между производителями в данной схеме двояка. Если мы начали использовать в агенте какой-то фирменный протокол, характерный для данной модели CE, то всё станет печально рано или поздно. А в случае использования более-менее стандартных протоколов, уже всё лучше. Здесь плюс. Не будем углубляться далеко, примем за данность, что здесь больше плюсов, чем минусов при умном подходе.
4. Ну и про расстановку агентов на сети скажем, что здесь всё, как в разделе 2.2. Можно включать ПО агента только там, где необходимо. Конечно, в цену CE-устройства уже может быть заложена стоимость агента, так как даже «бесплатное» ПО на самом деле субсидируется от иных доходов. Однако, часто минимальная цена устройства не предполагает отказа от встроенного ПО, поэтому сэкономить можно только полностью отказавшись от устройства, что тоже не всегда удобно. Констатируем, что большое число плюсов здесь безусловно перевешивает нечастые минусы.
Раздел 2.4. Так, дополнительные устройства или существующие?
Михаил Евграфович говорил, что в жажде подвига трепещет живое человеческое сердце, скрывается пытливый и никогда не успокаивающийся человеческий разум. Памятуя это, мы попробуем создать гибрид рисунков 10 и 11.
Рисунок 12. Гибридная схема. Агент-инициатор включен безопасно T-образно, сопряжённый ему использует пользовательское оборудование.
Зачем мы это сделали? А для того, чтобы придать рабочему варианту гибкость, которой несколько лишены его предшественники. Мы не будем класть все яйца в одну корзину, давая службе эксплуатации сети возможность выбора. И не забудем разобрать по пунктам уже знаменитый список сомнений.
1. Дополнительные точки отказа в данной схеме контролируются теми, кто создаёт включение. Плюсы схем 2.2 и 2.3 можно суммировать.
2. Связанная производительность так же полностью контролируется. При необходимости в нужных точках можно использовать нужное число дополнительных агентов. Опять плюсы.
3. Привязки к производителю так же контролируются. Где-то рационально использовать патентованные решения, а где-то стандартные. Если на сети уже есть какая-то технология, то можно и использовать её. Опять плюсы.
4. Про расстановку и говорить стыдно. Очевидно, что можно устанавливать и включать агенты только там, где реально необходимо, и при этом решение будет вписываться в доступный бюджет. Вновь плюсы.
Напоследок заметим, что в качестве агента-инициатора можно использовать как встроенный в ПО, так и выделенный. То, что на рисунке 12 инициатор именно выделен, является рекомендованным, но отнюдь не обязательным. Умный подход — вот наш путь!
Под конец раздела, памятуя научный опыт, попробуем обозреть окрестности, держа в уме вопрос: а какие схемы используют уже существующие решения?
1. RFC-2544.
Как уже написано в разделе 1.5, мы не являемся сторонниками данного стандарта. Полный список аргументов мы обсудим позднее, а здесь упомянем, что схема включения DUT, даже в форме multiple, никак не относится к реальной сети, только к лаборатории. Поэтому схема включений может быть выбрана произвольно.
2. Y.1540.
Данный текст проработан уже лучше по сравнению с предыдущим, однако схема рекомендована только в виде рисунка 9, что не может быть признано удовлетворительным. Так как его минусы мы привели выше. Да и. кроме того, источником вдохновения для авторов стандарта послужил безусловно I.353, что хотя и понятно, но всё-таки для сетей стандарта TCP/IP странно. Ведь синхронного поведения тут нет априори.
3. vendor lock.
В этом пункте мы объединили всех производителей, как патентованных, так и просто недокументированных протоколов. Схемы включений могут быть разными, так как технологии отличаются. Однако, заметим, что большинство всё-таки склоняется к схеме на рисунке 12. Во многих случаях производитель, как уже и было сказано ранее, «рекомендует» закупать побольше устройств для расстановки на сети в виде дополнительных агентов. За подробностями отсылаем к соответствующим документам.
4. G.8013.
Поскольку данный стандарт создан только для Ethernet-сетей канального уровня, мы считаем, что здесь, где обсуждаются сети TCP/IP, использовать его схемы неразумно.
5. iperf3.
Данное свободное программное обеспечение может быть установлено на любое устройство, поддерживающее ОС Linux/BSD и им подобные. Хотя схема включений в документации и не конкретизирована, можно сказать, что она аналогична рисунку 11 или рисунку 12 в зависимости от того, используется ли конкретная аппаратная платформа в виде CE или нет. Так как указанное прикладное ПО встроено в ОС общего назначения, но при этом не умеет оперировать с трафиком транзита.
6. ping, bwping.
Упомянутое ПО широко используется и в целом схема полностью аналогична случаю с iperf.
7. RFC-5357 (TWAMP), RFC-4656 (OWAMP).
Поскольку в обоих стандартах описываются протоколы, реализуемые на том или ином устройстве в ОС или прикладном ПО, можно говорить что схема включений аналогична рисунку 11 или рисунку 12, как и в предыдущих двух случаях.
Итак, аргументы мы привели. Рекомендации по использованию рисунка 12 как базового дали. Вам следует решить, что делать в реальности. Мы не навязываем свой метод, однако сами используем на практике именно его. Если у вас есть новые аргументы в пользу чего-то иного, с удовольствием узнаем ваше мнение.
Раздел 2.5. Настройки теста
Используя логичный, прямо по Станиславскому, подход о сплошном стремлении к сверхзадаче, мы решили основную часть проблем включения дополнительных агентов или использования встроенных в ПО, создав правильную схему. Настало время поговорить о настройках.
Начнём с обсуждения, каким протоколом следует пользоваться для расчёта метрик. Для этого вспомним нашу сверхзадачу — дать экономически обоснованный путь для отслеживания качества на сети. Она может быть выполнена только при использовании широко распространённых протоколов, то есть TCP, UDP, ICMP. Экзотические способы можно, конечно, рассматривать, ведь тот же UDP-lite уже давно существует, вот только их широкое внедрение будет либо затруднено, либо мы попадём в ловушку одного-двух производителей, а это явно то, чего хочется любому оператору связи в последнюю очередь.
Далее докажем, что для создания теста наиболее рационально использовать прикладное ПО, а не системное. Многие производители настойчиво рекомендуют путь соединения с ядром ОС с разной аргументацией, но отнюдь не мы. Итак:
1. Реализация в виде модуля ОС сразу ограничивает нас только определёнными аппаратными платформами. Так как универсальная системная разработка под несколько ОС будет стоить дорого, как при заказе сторонней организации, так и внутри. Неразумно тратить бюджет, там где можно его сэкономить.
2. Мультиплексирование потоков трафика, например, для случая одновременного запуска тестов в одном или разных направлениях, теперь возлагается на наше ПО. Сможет ли разработчик повторять действия создателей ОС, это большой вопрос.
3. Хотя с первого взгляда кажется, что при системной разработке может быть компенсировано время переключения контекста ОС при подсчёте задержек, это не совсем так. Ход часов в ОС всё равно зависит от шага таймера, меньше этого получить метки времени нереально. Подменять же системный таймер — это большая глупость. Ну и, строго говоря, более точные метки времени можно получать и в прикладном ПО, хотя и не во всех ОС. Да и время переключения контекста существенно меньше времени передачи пакетов через сеть.
4. Нам важно получить метрики, максимально близкие к пользовательскому ожиданию. А ведь рядовой потребитель услуг работает в сети с прикладным ПО в большинстве случаев.
Исходя из всех перечисленных причин мы и полагаем, что использование обычного прикладного ПО (даже простого ping!) вместо системного – это не только разумный, но и эффективный способ для проверки качества сети TCP/IP.
Теперь обсудим протоколы. Очевидно. что TCP для процесса расчёта метрик подходит слабо, ведь он скрывает для пользовательского ПО потери. Собственно, для этого его и придумали. Однако нам требуется, чтобы проблемы на сети отражались на доставке пакетов. Поэтому TCP – неверный выбор.
Как насчёт ICMP? Ведь он, собственно, для этого и предназначен, как кажется? Да и какой протокол внутри ping? Однако, на прикладном уровне (впрочем, на системном тоже!) вновь возникает проблема мультиплексирования потоков при одновременной посылке и приёме пакетов, упомянутая выше. Это заставляет обрабатывать некоторое количество «мусорных» пакетов, которые изначально не предназначались данному сокету. Что увеличивает нагрузку на процессор без особой пользы. Так что, минус всё-таки есть.
В противовес TCP и ICMP у протокола UDP – одни достоинства. И все ошибки передаются на пользовательский уровень. И мультиплексирование работает отлично. Прямо на уровне ядра ОС. Да и большинство приложений использует UDP, что дополнительно позволит проверять доступность пропуска трафика того или иного вида по сети. Поэтому его мы и рекомендуем.
Итак, формулируем итог.
Требование 1
Для расчёта метрик необходимо использовать прикладное ПО, которое реализует один из протоколов OP, TP, TNP, TAP на базе транспортного протокола UDP (предпочтительно) либо ICMP.
Теперь очень важный момент. Необходимо решить, должны ли быть тесты постоянными или исполняться только время от времени. С первого взгляда, памятуя, что традиционно в связи используется длительный BER-тест, хочется запустить его аналог на постоянной основе, время от времени считывая текущие результаты. Но:
1. Это постоянная нагрузка на сеть, что не разумно. Ведь у нас сеть с коммутацией пакетов, а мы пытаемся превратить её в сеть с коммутацией каналов!
2. В BER-решении нет гибкости, так как полносвязное тестирование между всеми точками сети создать на практике нереально. А ведь именно к этому и подталкивает постоянность тестирования.
3. Начальная инициация соединения и его завершение для любого вида протокола сами по себе хорошо моделируют поведение пользователя в отличие от постоянного пропуска искусственного трафика. А служба эксплуатации работает именно для пользователя.
4. В случае регулярного пропуска мы теряем гибкость настроек, особенно P[s], B[s], C[s], которые придётся фиксировать на длительный срок. Это опять-таки усложняет жизнь.
5. Простой алгоритм 1 на приёме усложнится. Нам кажется, лучше выбирать разумные и простые решения, чем пытаться объять необъятное.
Исходя из всего вышеперечисленного, вводим определение.
Определение 76
время ожидания запуска очередного теста.
Понятно, что на этот период времени нужно наложить ограничения. Так как слишком частый запуск осложнит жизнь, причём бесцельно. Фактически вновь приближая нас к BER-тестированию со всеми его «особенностями». В то же время слишком редкий запуск теста будет вести в перспективе к получению информации об ошибках от пользователя, а мы-то как раз хотим этого избежать. Поэтому формулируем следующее неравенство.
Требование 2
время ожидания запуска очередного теста должно превышать время тестирования, которое должно быть больше периода ожидания прихода очередного пакета и не превышать одного часа.
Нижняя граница частоты запуска теста, исходя из того, что писалось в разделе 1.4, на наш взгляд не должна быть меньше 60 секунд, а верхняя не должна превышать одного часа, так как за это время, как показывают личные наблюдения, средний пользователь способен прорваться через три уровня первичной поддержки до реальной службы эксплуатации с сообщением: «проснитесь, у вас сеть упала».
Вспомнив все условия применимости алгоритма 1, создадим итоговую таблицу 1 с рекомендованными настройками, чтобы службе эксплуатации при реальном запуске тестов не надо было долго искать подходящие под поставленную задачу параметры.
В левой колонке указаны либо протоколы общего назначения, либо конкретные, предназначенные для пропуска голосового трафика.
Во второй указывается скорость генерации тестового трафика. Мы уже говорили об этом, но не поленимся повторить, что именно этот параметр большинство пользователей сети считают главным, поэтому от него проще всего и отталкиваться.
В третьей — размер полезной информации в пакете UDP/ICMP. Так как именно это определяет характер трафика пользователя.
В четвёртой колонке указано рекомендованное нами число пакетов для данных B[s] и P[s], вычисленное по выше указанным условиям с тем, чтобы тест продлился 30 секунд. Этот период — разумный компромисс между полнотой сбора данных и тестовой нагрузкой на сеть.
В пятой мы специально привели вычисленный параметр IPI[s], которые некоторые недобросовестные производители сетевых устройств используют как базовый в настройках на своих аппаратных платформах. Чуть ниже мы поговорим о причинах этой нелюбви.
В шестой указано вычисленное по формуле из раздела 1.4 время тестирования. Не забывайте, что T[test] задаёт время работы генератора, а реальное время приёма T[r] или T[p] будут отличаться от него, как правило в сторону роста, в зависимости от поведения сети!
В последних же трёх указаны частоты запуска тестов T[freq], которые на наш взгляд необходимо использовать. При этом вы вольны выбрать из минимального, рекомендованного как нормальный и максимального.
Таблица 1
Информации вышло много, поэтому откроем пресс-конференцию.
В: «Почему некоторые строки подсвечены серым?» - спрашивает нас неравнодушный читатель.
О: Дело в том, что эти размеры пакетов хотя исторически и были, скажем мягко, несколько заметны в общем трафике, в настоящее время не представляют практической ценности, то есть факультативны. Пользователей, активно использующих похожие размеры, вы вряд ли сможете найти. Следовательно, проверять прохождение пакетов указанного размера неразумно, эта та работа, которой следует избежать. Поэтому мы строки сохраняем в таблице, но в практической деятельности рекомендовать не можем.
В: «Почему все настройки у кодеков VoIP такие похожие?»
О: Да потому что там как раз важен параметр IPI[s], он один и тот же, ведь фактически это шаг квантования в АЦП, а скорость в данном случае является вычисляемым параметром.
И раз уж здесь зашёл разговор про межпакетный интервал, сразу скажем, почему мы его так не любим (см. раздел 1.4). Дело в удобстве эксплуатанта. Известные производители сетевых устройств из одной солнечной области одной далёкой страны хотя в целом и неплохи для сетевых задач, но вот вместо указания скорости на своих патентованных решениях проверки качества предпочитают межпакетный интервал. Причины очевидны — встроенной в аппарат ОС проще получить от конфигуратора сразу готовый параметр, чем его пересчитывать, что хорошо описывается русской пословицей «Лень раньше меня родилась». Но вот посмотрите на таблицу 1. Там заметно, что как только меняется P[s], то на той же скорости нам необходимо пересчитать IPI[s] (за исключением случаев пропуска VoIP-трафика). Удобно ли это администратору? Нет, потому что пользователь сети закупил пропускную способность и, коль скоро мы проверяем качество сети как единого целого, то и исходным параметром у нас должна быть скорость, а не загадочный межпакетный интервал. Как только мы хотим проверить, доступно ли 10% от заказанной пропускной способности, нам достаточно умножить заказанное на 0.1 (ну или разделить на 10, если вам так удобнее) и получить правильный B[s]. А сколько расчётов нужно сделать, чтобы получить правильный IPI[s]? А если сменился P[s], это получается надо менять два параметра вместо одного? Вот так номер! Робот должен выполнять человеческие указания строго по Азимову, а человеку должно быть удобно — вот наш принцип. А не наоборот! Впрочем, памятуя, что в жизни ситуации могут быть разные, и если вам досталась в наследство сеть с подобными устройствами, глупо их не использовать, ведь капитальные затраты уже понесены. Для таких случаев мы приводим поле IPI[s], чтобы в случае необходимости вы могли взять готовое значение, не проводя дополнительных расчётов.
В: «Почему в размерах пакетов вы не следуете рекомендациям RFC-2544?»
О: Вопрос правильный, но ответ простым быть не может. Всё дело в том, что мы, в отличие от авторов стандартов, всегда шли от практики. «Теория без практики —-мертва!» - так ведь говорили до нас и будут ещё долго говорить после нас. Поэтому пользуясь случаем подвергнем сомнению догмы стандартов, как и положено прилежным связистам с высшим образованием. Сразу опустим мнение авторов RFC-2544 о Token Ring, мы его в России вживую так и не увидели, и опустим почивший FDDI. Остаётся вечно живой, как один политический деятель, Ethernet.
Заметим, что в указанном тексте написано английским по белому ”frame sizes”, а значит речь идёт о полной длине на втором уровне, а не о размере поля данных. Поэтому, 64 на уровне IP-протокола превращается в 46, а 1518 в 1500. Не забываем, что P[s] мы указываем как полезную нагрузку UDP-пакета (см. раздел 1.4). Следовательно, 46 превращается, как те знаменитые брюки, для IPv4 в 18, а 1500 в 1472. Что же касается IPv6, то внезапно выясняется, что 64-байтовый Ethernet frame никак не может поместить даже заголовок IPv6-пакета, включающего UDP. «Удар состоялся, заседание продолжается» - как говорил сын турецко-подданного. В общем, пора брать власть и командовать парадом, не обращая внимания на дутые авторитеты. Какой вообще минимально необходим пакет данных? Проанализировав несколько протоколов контроля качества, как документированных, так и зачем-то патентованных, мы честно скажем — без наличия как минимум 16 байт полезной нагрузки у вас не получиться разумно измерить даже статистические величины! А лучше 20. А ещё лучше 40. Потому что в этом случае в полезную нагрузку помещаются почти все протоколы. Ну и дополнительным аргументом будет фраза из RFC-791, посвящённая минимально необходимому размеру IP-пакета без фрагментации. Там указано число 68, что на уровне UDP равно 40. Отличный выбор! На уровне Ethernet это будет 86 байт для IPv4 и 106 для IPv6 нагрузки внутри пакета. Не забыли, что свежие адресные типы тоже крайне желательны к поддержке? Мы помним, а авторы «стандарта» об этом забыли. И после этого многие продолжают ставить ЭТО в пример и техзадание? Да вы смеётесь!
Идём дальше. 128 (на уровне UDP – 82 и 62) имеет только теоретический смысл для сугубо специфических протоколов, если вам хочется, то можете по формулам сами всё рассчитать, а для 256 (на уровне UDP – 210 и 190) мы хотя и привели значения, но не рекомендуем к постоянному использованию.
Теперь про 512 (на уровне UDP 466 и 446). Такой трафик у пользователей возникать может, поэтому для варианта адресации IPv6 мы его и указываем. Что же касается IPv4, то большого смысла проверять фреймы именно 512 байт за пределами лаборатории нет, так как доблестные писатели стандартов пропустили существенно более важный близкий размер – 576 байт пакета IP (фрейм Ethernet 594, UDP размер 548). Такой пакет должны обрабатывать все устройства IPv4 по RFC-791, так как это своего рода MTU последней надежды. и поэтому его как раз следует тестировать время от времени на реальной сети, а вот 512 нужно оставить для студенческих изысканий в лабораторных работах.
Наиболее любопытный вопрос касается фреймов размером 1024 и 1280. Во-первых, мы не видим смысла тестировать трафик и тем и другим. Так как размеры близки, реальные проблемы с прохождением трафика только определённого размера (далёкого от стандартного максимального MTU!) из этих двух могут возникать разве что в специально созданных выделенных средах тестирования. Во-вторых, фрейм размером 1280 выбран авторами RFC-2544 строго по русской пословице «слышал звон, да не знает где он». Потому что в реальности это явный аналог минимального необходимого MTU для IP-протокола стандарта v6! А не размер Ethernet-фрейма! Который должен в этом случае равняться 1298 (на уровне UDP 1232) конечно же. Но, это прошло мимо внимания писателей и читателей, не говоря уже про переводчиков, поэтому нам приходится взваливать на свои плечи нелёгкую ношу разъяснений с аргументацией. Что же касается стандарта IPv4, то мы не видим большого смысла проверять фрейм 1280, поэтому выбрали 1024 (на уровне UDP 978). Теперь читатель-друг понимает, что стандарты нужны не для того, чтобы им слепо следовать, как рекомендуют директора по маркетингу, близкие к деньгам, но далёкие от науки, а для того, чтобы их модифицировать под реальную жизнь. Вы всё ещё поклоняетесь RFC-2544? Добро пожаловать в ад критики. En guarde!
Ну а пакет максимального для стандартного Ethernet размера 1518 (на уровне UDP 1472 и 1452) мы, разумеется, включаем в таблицу 1 без вопросов. Более того, рекомендуем его использовать регулярно.
Тяжкие объяснения завершены, но читатель неутомим, проходит финтом по правому краю и навешивает прямо в нашу штрафную:
В: «Ну ладно, список размеров понятен и аргументация разумна. Но в реальной сети неужели надо, чтобы все размеры использовались для постоянного тестирования да ещё и по всей сети?»
О: Правильный вопрос. А правильный ответ мы сформулируем в виде двух требований:
Требование 3
Для регулярного тестирования сети следует использовать минимально необходимый размер пакета P[s] и минимально необходимую скорость B[s].
Рекомендован размер пакета от 40 до 60 байт и скорость от 32 до 64 килобит в секунду.
Частота запуска тестов T[freq] рекомендована от 300 до 600 секунд.
Требование 4
Для тестирования сети на нерегулярной основе следует использовать следующие размеры пакета P[s]:
1. MTU последней надежды (IPv4 548, IPv6 1232).
2. Максимальный MTU не Jumbo (IPv4 1472, IPv6 1452).
3. Дополнительные размеры следует применять по итогам предварительного анализа.
Скорость B[s] следует использовать минимально необходимую. Рекомендована от 32 до 64 килобит в секунду.
Настройки следует хранить постоянно для упрощения будущего тестирования, а вызывать — по мере необходимости либо несколько раз в часы наименьшей нагрузки.
Итак, с настройками скоростей, размеров пакетов и их числом мы разобрались и нужные требования сформулировали. Однако в современном мире сети TCP/IP используют класс сервиса в пакетах для того, чтобы разделять потоки разных приоритетов. Как быть? Надо сформулировать ещё одно требование.
Требование 5
При разделении трафика на сети на несколько классов C[s], регулярные тесты следует проводить в каждом классе, который может быть предоставлен пользователю.
Это усложняет жизнь? Да, количество необходимых тестов возрастает. Однако, если мы предоставляем пользователю возможность разметки трафика, то уж конечно нам следует и контролировать как правильность разметки, так и правильную конфигурацию сети. Так что разные тесты для разных классов — это данность, которую следует принять.
Итак, требования 1-5 достаточно полно описывают рекомендуемые нами настройки тестов для получения метрик качества. Теперь займёмся выбором протоколов тестирования. Для этого нам придётся определить, что нам нужно рассчитать в первую очередь, а что может и подождать.
Раздел 2.6. Метрики первой очереди
Хороший научно мыслящий связист всегда изучит, какие умные идеи были придуманы другими, пусть даже он уже и имеет собственное мнение. Поэтому мы тоже до начала формулировки своих требований к тому, что же хочется получить в итоге, рассмотрим стандарты и требования в Отрасли, равно как и иные существующие попытки собрать метрики под одну крышу.
Поскольку сети у нас TCP/IP, то первыми следует использовать наработки «Инженерного совета Интернета», более известного в широких кругах под английской аббревиатурой IETF. То есть, нас ожидает реестр, созданный в RFC-8912. Надо сразу заметить наперёд, что в данном случае и вообще во всём разделе мы будем просто коллекционировать метрики, не конкретизируя подробностей их получения и тем более алгоритмы. Потому что нас интересует значимость, а как правильно считать и почему это надо делать именно так, мы уже выяснили выше.
Итак, что же вообще предлагает исследовать RFC-8912? Запишем в таблицу для наглядности.
Таблица 2
К сожалению, авторы RFC-8912 не сделали выбора, что же следует исполнять в первую очередь, а что может и подождать до лучших времён. Сразу отметём метрики для TCP и DNS, как очевидно наведённые, когда будет время, рассмотрим и это. А пока заметим, что все параметры со страшными названиями, отпугивающими сами собой даже подготовленных людей, в сущности сводятся к потерям, задержкам и, по большим праздникам, дрожанию задержки. Запомним.
И поскольку не только "Инженерный совет Интернета", но и Международный союз электросвязи подумал за нас, хотя и не столь интенсивно, изучим ещё и стандарты класса Y.15xx.
Таблица 3
Здесь, по сравнению с предыдущим случаем, ситуация с выбором приоритетов уже лучше. Дело в том, что в связанном стандарте Y.1541 определяются требования к метрикам качества для отражения доступности сети в целом. И они после приведения к текущим, уже знакомым нам размерностям выглядят как неравенства:
Класс 0 (голос, видео)
Класс 1 (голос, видео через спутник)
Класс 2 (сигнализация, интерактив)
Класс 3 (транзакции, несрочный интерактив)
Класс 4 (средняя срочность, видеопоток)
Класс 5 (обычный поток)
Несложно видеть, что основные метрики вновь сводятся к потерям, задержкам и, для особо срочных данных, дрожанию задержки. Запишем второй раз. На сами же цифры в данный момент не стоит обращать внимания, мы этим ещё займёмся. Festina lente.
Теперь пришёл момент вспомнить, что все сети связи, в том числе и TCP/IP, как правило, существуют не в безвоздушном пространстве, хотя и это иногда случается, а чаще всего работают согласно государственным требованиям. А мы, как вы заметили, находимся в России, да и говорим по-русски. Поэтому изучим, чего же хочет министерство, время от времени меняющее название, от подопечных эксплуатантов. Опустим подробности и просто прочитаем те части руководящих документов, которые хотя и многолетней давности, но отнюдь не устарели в некоторых важных частях. Не забываем, что нам нужны лишь сами названия метрик. Итоги соберём, как уже стало привычным, в таблицу.
Таблица 4
В итоге можно сказать, что министерство строго по стандартам МСЭ регламентировало к контролю оператором потери, задержки, для особо срочных данных, дрожание задержки, и добавило к ним пропускную способность. Запишем третий раз. Не пропадать же добру, раз его создавали!
Ура! Мы почти всё собрали, скажет торопливый коллега, но тут-то мы его и поправим, как любил это делать гражданин с двойной фамилией, произведения которого входили в школьную программу в нашей молодости. Поскольку стоит посмотреть, а что, собственно, предлагает прикладное программное обеспечение для наших целей. Оно-то какие метрики подсчитывает? Изучим.
1. Реализации RFC-2544.
Тут всё строго, читаем методику и видим: Throughput, Latency, Frame loss rate. Опустим то, что на самом деле все эти параметры означают совсем не то, что нам нужно. Критика у нас будет ниже. Пока фиксируем: пропускная способность, задержки, потери.
2. vendor lock.
Здесь мы объединим сразу трёх известных производителей оборудования и ПО, чтобы три раза не вставать.
Первый, со штаб-квартирой во граде святого Иосифа Гваделупского, предлагает рассчитывать метрики, приведённые на рисунке 13. А само это предприятие будем в дальнейшем в целях конспирации именовать V1. Вначале, честно говоря, мы хотели именовать его правильной русской буквой "Ы", чтобы никто не догадался, отдав тем самым дань уважения большому русскому режиссёру, но, подумав, решили уменьшить чад кутежа в книге до более разумных пределов.
Рисунок 13. Метрики производителя сетевого оборудования №1.
Второй, со штаб-квартирой в небольшом солнечном доле, рекомендует несколько иное, приведённое на рисунке 14. Ему мы дадим гордое имя V2.
Рисунок 14. Метрики производителя сетевого оборудования №2.
Ну а третий, со штаб-квартирой во граде королевы в государстве президента, рекомендует вообще самый простой набор, приведённый на рисунке 15, за который, не побоимся этих слов, должно быть стыдно! Впрочем, критика критической критики ещё предстоит. Ну а имя V3 будем применять для ссылки (в Сибирь. Убирать снег. Весь!).
Рисунок 15. Метрики производителя сетевого оборудования №3.
Подводя итоги, фиксируем, что суммарно все зарубежные создатели умеют рассчитать потери, задержки, дрожание задержки, пропускную способность, нарушение порядка. Записали.
3. iperf3.
Неплохая утилита со свободным исходным кодом, изначально предназначенная для замера BW[r] и BW[p], а теперь умеющая вдобавок посчитать LR[r], LR[p], OR[r], OR[p], APDV[p] (неясно по верному ли алгоритму!) и ARTT. В блокнотик идёт новая запись.
4. ping.
Программа эта настолько широко знакома пользователям, что кажется, про неё всё известно. Однако, авторам приходилось встречать необычные обвязки вокруг этой простой утилиты. Обычно ping умеет выдавать готовый результат только в виде LR[p] и ARTT. Однако, с помощью дополнительных несложных действий, которые мы оставим уважаемым читателям в качестве домашнего задания, он начинает уметь подсчитывать и RDV[p], APDV[p] и AMDV[p]. Отметим и это на память.
5. bwping.
Улучшенный ping, в который уже можно передать параметр B[s], что, конечно же, следовало сделать ещё в оригинальном коде. Выдаёт готовый результат в виде LR[p], ARTT и BW[p]. Несложным дописыванием вы самостоятельно можете реализовать RDV[p], APDV[p] и AMDV[p]. Полезно, пора записать.
6. Реализации RFC-5357 (TWAMP).
Хороший стандарт, которым производители попытались закрыть нишу единства технологий. Не без недостатков на наш скромный взгляд, однако попытка очень и очень достойная внимания. Многие производители коммутаторов и маршрутизаторов внедрили этот стандарт в своё оборудование, что позволяет его использовать в качестве как агента-инициатора, так и сопряжённого (отзывающегося на запросы). Мы видели не меньше четырёх разных видов реализации. Поэтому опишем максимально подробно, что умеет данный протокол. Все реализации умеют рассчитывать LR[r], LR[p], ARTT, AD[r], AD[p] и OR[p] . Многие умеют вдобавок APDV[p] и APDV[r] . Некоторые умеют RR[p], BW[p], SR[p], LBW[p], RDV[p], RDV[r], AMDV[p], AMDV[r]. Мы же говорили — стандарт вполне неплохо продуман. Запишем не только список, но и имя TWAMP на память!
7. Реализации RFC-4656 (OWAMP).
Первая версия предыдущего стандарта, которая не нашла столь же широкого применения. О причинах мы не судим, оставим их другим, просто подсчитаем, какие метрики OWAMP поддерживает, а какие несложны в реализации с его помощью. Безусловно, всякая реализация должна суметь подсчитать LR[r], AD[r] и OR[r]. А самые лучшие должны также суметь увидеть и RR[r], BW[r], SR[r], LBW[r], RDV[r], APDV[r] и AMDV[r]. Фиксируем это на твёрдый бумажный носитель.
Ох, что-то переполнился уже блокнот, "ещё немного и рванёт", нельзя ли сделать нагляднее? Можно. И нужно! Мы любим таблицы и любим наглядность.
Таблица 5
Уф, «орешек знанья твёрд, но всё же, мы не привыкли отступать». Так что, раскололи. Формулируем итог в виде требований к поддержке метрик качества прикладным ПО для тестирования сети TCP/IP.
Требование 6
Прикладное программное обеспечение, используемое для расчёта метрик качества на сети TCP/IP, обязано уметь рассчитывать круговые потери LR[p], круговые задержки ARTT, односторонние задержки AD[p], AD[r], один из видов дрожания RDV[p], APDV[p] или AMDV[p].
Прикладному программному обеспечению, используемому для расчёта метрик качества на сети TCP/IP, крайне желательно уметь рассчитывать потери в обоих направлениях LR[p], LR[r], перекраску в обоих направлениях RR[p], RR[r], круговую скорость BW[p].
Прикладному программному обеспечению, используемому для расчёта метрик качества на сети TCP/IP, желательно уметь рассчитывать скорости всех видов BW[p], BW[r], LBW[p], LBW[r], изменение порядка всех видов OR[p], OR[r], все виды дрожания RDV[p], RDV[r], APDV[p], APDV[r], AMDV[p], AMDV[r], сдвиг пути всех видов SR[p], SR[r].
Метрики, таким образом, мы исчерпали, и начинаем черпать яства из посуды на протокольной кухне.
Раздел 2.7. Выбор протокола
Поэт писал, что дьяволу служить или пророку — каждый выбирает для себя. Выбор правильного протокола тестирования сродни подобному экзистенциальному выбору. Но прежде чем это делать, мы добавим наглядности в текст, ибо что-то давно у нас с вами не было приобщения к прекрасному, не так ли?
В разделе 1.8 мы привели несколько определений — OP, TP, TNP, TAP, которые теперь стоит проиллюстрировать. Кроме того, из раздела 2.1 известно, что такое агент-инициатор и сопряжённый агент (Q1 и Q2), и это тоже явно хочется изобразить наглядно. Потому что рисунки помогают нам понять, а из каких собственно модулей должны состоять агенты как в идеале, так и в реальности. Начнём с протокола типа OP.
Рисунок 16. Блок-схема агента-инициатора Q1 для протокола OP.
где
Модуль запуска по расписанию.
Модуль генератора теста по переданным параметрам.
Модуль подведения итогов и записи метрик.
Передача настроек теста от модуля запуска к генератору. При этом P[s], N[s] — обязательные, а B[s], C[s] — факультативные. O[s] определяется автоматически.
Управляющее соединение от Q1 до Q2.
Поток тестового трафика от Q1 до Q2.
Приём накопленных метрик от Q2 на Q1.
Теперь приведём блок-схему стороны приёма данных.
Рисунок 17. Блок-схема сопряжённого агента Q2 для протокола OP.
где
Модуль ожидания соединения.
Модуль приёма на Q2 трафика, создаваемого Q1.
Передача полученных настроек и результатов расчётов от модуля к модулю.
Пора изложить подробности. Основным модулем агента-инициатора является, безусловно, модуль расписания. В нём хранится целый список информации, как о параметрах тестирования (P[s], N[s], B[s], C[s]), так и служебные (например, T[freq]). По мере наступления момента запуска очередного теста, этот модуль передаёт генератору трафика настройки, в которых могут быть как обязательные параметры, так и зависящие от конкретной реализации. На блок-схеме это специально выделено указанием либо выше стрелки передачи, либо ниже. Опытный читатель уже мог заметить, что модуль похож на известную программу cron, которую любой Unix-администратор знает очень хорошо.
Генератор устанавливает управляющее соединение от Q1 до Q2 тем или иным методом, тем самым сообщая модулю ожидания соединения на Q2 о своём желании начать тестирование. Модуль ожидания даёт команду приёмнику начинать приём, что тот и делает. Генератор создаёт тестовый трафик (бледно-жёлтая стрелка), который принимается приёмником, а данные расчёта метрик фиксируются в модуле подведения итогов.
После окончания тестирования (см. подробности в алгоритме 1) модуль подведения итогов Q2 передаёт модулю подведения итогов Q1 все накопленные метрики. Это может делаться как по управляющему соединению, так и иначе, в блок-схеме подробности реализации не важны. Так же пока не важно, как распорядится модуль записи метрик Q1 с полученной информацией. Мы, напоминаем, пока выбираем протоколы тестирования, и данные блок-схемы нужны для лучшего понимания уважаемыми читателями тех или иных наших выводов.
На наш взгляд, всё понятно. Не забудем здесь отметить, что именно по данным блок-схемам реализованы стандарт RFC-4656 (OWAMP) и популярная свободная программа iperf3. Дополнительно скажем, что вендор №3, более известный как V3, в своей популярной программе фактически дважды повторяет такое же поведение, просто меняя направления потока трафика в рамках одного запуска. Ну а модуль расписания по понятным причинам вынесен на внешние ресурсы, то есть руки администратора сети.
Односторонние протоколы — это хорошо и относительно просто, но в мире существуют и другие. Начнём с простого протокола TP (относительно сложный инициатор и относительно простой сопряжённый агент при дуплексном трафике).
Рисунок 18. Блок-схема агента-инициатора Q1 для протокола TP.
где
Передача настроек модулю приёма на Q1 трафика, создаваемого Q2.
Поток тестового трафика от Q2 до Q1.
И не забудем, что сторона приёма данных тоже изменилась.
Рисунок 19. Блок-схема сопряжённого агента Q2 для протокола TP.
где
Передача настроек теста от модуля приёма к модулю генератора. При этом P[s] — обязательный, а N[s], C[s] — факультативные. O[s] определяется автоматически. B[s] фактически не используется ввиду зависимости генератора (см. раздел 1.8).
Что нового в Q1 протокола TP по сравнению с протоколом OP? Во-первых добавился приёмник, теперь тестовый трафик одновременно и принимается, и получается. Во-вторых модуль подведения итогов сразу получает информацию от приёмника, и ему не нужно дополнительно после сессии проводить излишнюю работу. В-третьих, модуль подведения итогов может рассчитывать не только однонаправленные, но и двунаправленные, да и круговые метрики.
А что изменилось в Q2? У него отобрали модуль расчётов и добавили модуль генератора. Это несколько изменило структуру программного обеспечения, которое реализует весь этот функционал, и, поскольку генератор в данном случае упрощён донельзя, в предельном случае он зависит только от размера пакета P[s], а сам вызов функции sendmsg(2) нельзя признать сложным, то можно сказать, что и весь функционал ПО Q2 стал проще для реализации. Более того, на рисунке 20 мы специально приводим пример «эхо»-реализации функционала Q2 в качестве иллюстрации простоты.
Рисунок 20. Блок-схема сопряжённого агента Q2 для протокола TP типа «эхо».
Видите, как всё просто? Приняли пакет и ответили обратно в адрес отправителя, возможно, внеся некоторые небольшие изменения в пакет данных. Эта простота позволяет либо вынести реализацию Q2 на уровень стандартного модуля ОС, либо на уровень ядра ОС, либо вообще реализовать в микросхемах. Удобно? Ещё бы! Не мы первые кто это заметил, поэтому подробности желающие могут поискать в RFC-792. Умный читатель уже понял, что тем самым мы намекаем о вездесущем ICMP-эхе. Ну к UDP-эху сказанное тоже относится, конечно же.
А теперь о том, кто же работает по подобной схеме для замеров качественных метрик. По рисункам 18 и 20 работают: ping, bwping, RFC-2544 (именно! читаем внимательно!), и вендор №2, более известный как V2. Естественно, для ping, bwping модуль расписания обычно вновь вынесен на руки администратора, впрочем, могут быть и решения от систем мониторинга, которые иногда в пределе простоты ограничиваются простым запуском через cron. А по рисункам 18 и 19 работают: RFC-5357 (TWAMP) и популярный вендор №1, более известный в народе как V1. Что же касается Y.1540, то опустим занавес стыда перед этим стандартом, поскольку определив кучу метрик, аналогично I.353, авторы так и сподобились создать хоть что-то, минимально похожее на протокол тестирования. Поневоле вспомнишь бессмертную цитату про съеденные деньги на заготовке рогов и копыт посреди упоительной жизни.
Внимательный читатель, наслаждающийся нашей книгой с карандашом в руках, а не только ради литературных отступлений от тяжёлой доли связиста, уже заметил, что неторопливо, но неуклонно мы перечислили все протоколы, упомянутые в прошлом разделе, и уже кричит: «А протоколы TNP и TAP откуда возьмутся? Они вообще реализованы?»
Давайте вначале помечтаем. В любом техническом задании, которое пишет оператор связи для того, чтобы либо внутренний отдел, либо сторонний подрядчик создал нечто, что оператору нужно, обычно требования, мягко говоря, завышены. Иногда, на всякий случай, чтобы вытрясти из подрядчика лишнее и при этом минимально потратиться, туда вписывается даже фаза Луны и солнечные затмения. Вот для такого случая нами и придуман специальный термин — Ideal Quality Measurer или сокращённо IQM. Для тех кто привык к русской терминологии, мы тоже постарались и назвали его ИАИ (Идеальный Агент Измерений). Есть ли он в реальности, вопрос не столь важный, ведь "You have to have a dream so you can get up in the morning". Без этого шесть «Оскаров» так и останутся мечтой.
Итак, идеальная схема устройства Q1.
Рисунок 21. Блок-схема агента-инициатора Q1 для протокола TNP.
где
Передача настроек теста от модуля запуска к генератору. При этом P[s], N[s], B[s] — обязательные, C[s] — факультативный. O[s] определяется автоматически.
Передача настроек модулю приёма на Q1 трафика, создаваемого Q2. При этом P[s], N[s] — обязательные, C[s] — факультативный.
Разница между рисунком 21 и рисунком 18 кажется минимальной. Однако она есть. ping, UDP-эхо и V2 такому требованию уже не удовлетворяют, ведь в их настройках не указывается скорость генерации теста. Плюс приёмник теперь всегда точно знает сколько пакетов надо принять, это немного облегчает алгоритм приёма.
Теперь создаём идеальную схему для Q2.
Рисунок 22. Блок-схема сопряжённого агента Q2 для протокола TNP.
Новых обозначений мы здесь не ввели, просто организовали все модули ПО таким образом, чтобы выжать максимум информации во время расчётов. Так, теперь по сравнению с прежними схемами работы Q2, скорость B[s] и число пакетов N[s] являются для сопряжённого агента обязательными параметрами. Это позволяет создавать два встречных потока трафика (бледно-жёлтая и розовая стрелки), что позволяет полностью эмулировать действия пользователя сети путём применения разных параметров, как это рекомендуется в разделе 2.5.
Осталось определиться с протоколом TAP. Он ничем особенным не отличается от TNP, кроме асимметричности скоростей генерации теста B[s] и B[r]. Это полезно в основном для нагрузочного тестирования, когда у пользователей явно однонаправленный характер запросов, однако и измерения качественных характеристик могут быть полезны при применении неравномерной нагрузки.
Рисунок 23. Блок-схема агента-инициатора Q1 для протокола TAP.
где
Передача настроек теста от модуля запуска к генератору. При этом P[s], N[s], B[s], B[r] — обязательные, C[s] — факультативный. O[s] определяется автоматически.
В отличие от рисунка 21, в нашем случае видно, что обе скорости передаются в генератор. Однако B[s] он использует в личных корыстных целях, а B[r] передаёт дальше на сопряжённый агент Q2 по управляющему соединению.
А сама сторона Q2 теперь выглядит так:
Рисунок 24. Блок-схема сопряжённого агента Q2 для протокола TAP.
где
Передача настроек теста от модуля ожидания к генератору. При этом P[s], N[s], B[r] — обязательные, C[s] — факультативный. O[s] определяется автоматически.
Изменения по сравнению с рисунком 22 минимальны. Из управляющего соединения берётся вместо B[s] скорость B[r], а всё остальное реализовано так же, как и раньше. Не боясь критики, мы смело заявляем, что на рисунках 23-24 приведены блок-схемы идеального агента для сбора статистических метрик качества сети TCP/IP. Более того, схема на рисунке 23 может применяться как идеальный агент-инициатор для любого типа протокола (OP, TP, TNP, TAP).
Допустим, агент-инициатор Q1 собран по схеме 23. А сопряжённый ему Q2 по схеме 17. Будет ли работать подобное? При условии, естественно, что протоколы сопряжения совместимы, отсутствие входящего тестового трафика позволит приёмнику Q1 завершить работу заранее, а модуль подведения итогов на Q1 запишет только односторонние данные, полученные от Q2, чего мы и добиваемся в итоге.
Далее, пусть Q2 собран по схеме 19. Приёмник на Q1 примет все данные, которые отослал генератор Q1 и завернул генератор Q2, опять-таки при условии совместимости протоколов. Таким образом, мы получим все нужные метрики, так как B[r] фактически игнорируется стороной Q2.
То же самое происходит и со схемой 20, это вы можете показать самостоятельно.
А в случае, когда применяется схема 22, нам достаточно по управляющему соединению правильно передать на Q2 скорость B[r] равную B[s], и поведение будет полностью соответствовать ожидаемому.
Итак, идеальный агент-инициатор представлен на рисунке 23. А как быть с идеальным сопряжённым? Увы и ах, не стоит забывать, что сеть работает в первую очередь для пользователей, вспомните сомнение 4 в разделе 2.1, а отнюдь не для измерителей, как бы они ни были настойчивы. Поэтому идеальный сопряжённый агент — это тот, который с минимальными дополнительными затратами способен обеспечить съём требуемых метрик. Вы уже догадались, что итоги предлагается собрать в таблицу? Да, так и будет. А точнее таблиц будет две.
В таблице 6 мы сведём воедино поддерживаемые настройки и метрики первой очереди из требования 6 и, более того, с помощью строгой математической формулы выставим итоговую оценку каждой технологии для агента-инициатора.
Расчёт итогов ведём следующим образом:
1. Если технология поддерживает настройку теста или метрику, выставляем базовую оценку 10, если либо поддерживает не полностью, либо требуется доработка, выставляем 5, если не поддерживает, выставляем 0.
2. Для расчёта дрожания задержки выбираем поддержку одного из алгоритмов, а не все. Так как в случае дрожания принципиально само наличие расчёта, а не полная поддержка всех способов.
3. Каждая базовая оценка умножается на весовой коэффициент. Весовые коэффициенты для настроек распределяются так: для P[s], N[s], B[s] — 20, для C[s] — 10, для B[r] — 5. Тем самым мы повышаем значимость базовых настроек и понижаем для второстепенных. Весовые коэффициенты для собираемых обязательных метрик первой очереди распределяются так: для LR[p], ARTT и одного из дрожаний (RDV[p], APDV[p], AMDV[p]) — 20, для AD[p], AD[r] — 10. Односторонней задержке приоритет понижен, так как обычно они собираются либо обе, либо ни одной, и справедливо рассматривать сумму их весовых коэффициентов равной аналогичному для ARTT. А для всех крайне желательных метрик первой очереди (LR[r], RR[p], RR[r], BW[p]) мы вводим коэффициент 15, чтобы подчеркнуть их значимость, но всё-таки не безусловную необходимость.
4. Все произведения суммируются в итоговую оценку.
Окончательные оценки выносим в последней строке таблицы 6, чтобы наглядно показать, какие технологии предпочтительны к применению. Вы можете проконтролировать наши расчёты, создав в любимом редакторе электронных таблиц контрольный пример. Сами расчёты здесь мы не приводим за их очевидностью.
Таблица 6
Всё вышло вполне логично. Самая простая технология V3, которую широко применяют в рекламе, тем не менее, самая простая. Ну и в самом деле, отсутствие настроек, расчёты только круговой задержки и скорости к этому печальному итогу и должны вести. Не слишком далеко от V3 ушёл стандарт RFC-4656 (OWAMP), ибо изначальный выбор одностороннего характера протокола, как видно, сыграл злую шутку с авторами.
Даже ping является более сложной технологией, так как он уже имеет некоторое число настроек и способен показывать задержки и потери и даже, при модификации кода, либо написании обёртывающего ПО вполне сможет рассчитать и дрожание.
Чуть выше ping стоит RFC-2544. Этот стандарт как не реализовывай, как не выводи на реальную сеть, хотя он и предназначен для отделённой среды тестирования (Isolated Test Environment), толку будет немного. Даже bwping, уж на что простая программа и не без ошибок (об этом будет разговор), и то умеет больше. А если туда дописать расчёт дрожания, то и ещё больше! Равно как и примитивная реализация слежения за качеством V2, сделанная скорее в целях имитации бурной деятельности, чем для реального использования заказчиком безусловно неплохих маршрутизаторов. Свободная же программа iperf3 умеет чуть больше bwping, не говоря уже про V2, поскольку сопряжённым агентом использует саму себя и имеет заметное число настроек. За счёт этого получает более высокую итоговую оценку.
Кто в лидерах? Производитель V1 и стандарт RFC-5357 (TWAMP) разделили уверенное второе место, а первое место занял наш идеал. Что и неудивительно.
Наш многоуважаемый читатель, не пропускающий ни одной строки, уже заметил, что чуть выше было обещано две таблицы, а приведена всего одна, причём с готовой оценкой технологий. Где же подвох? А нет такого! В таблице 7 будет приведена обобщённая информация, пригодная для формулировки окончательного требования к протоколам сбора метрик качества. Сформируем матрицу совместимости технологий. То есть, какие агенты-инициаторы будут совместимы с аналогичными сопряжёнными. При этом, как и в таблице чемпионата страны по футболу, где «Ростов» стремится к чемпионству, средняя диагональ будет заштрихована, так как протоколы внутри одной технологии совместимы сами с собой, конечно же, но нас интересует как можно сэкономить на внедрении!
Поэтому итоговая оценка совместимости технологии, выставляемая в последней строке, будет формироваться следующим образом:
1. Базовой оценкой будет итог из таблицы 6.
2. При полной поддержке технологией сопряжённого агента иного протокола, в общую сумму будет включаться половина от оценки из таблицы 6 для сопряжённого. Так как реализация только стороны инициатора предполагает не полный объём работы.
3. При частичной поддержке (например, возможности использовать UDP-эхо или ICMP-эхо в качестве подмены) будет применяться четверть от оценки сопряжённого агента на базе ping. Это логично, так как в любой ОС общего назначения сейчас есть реализация эхо либо на базе ядра, либо на базе системного ПО и большой заслуги в реализации здесь быть не может, в то же время необходимо немного стимулировать включение устройств общего типа в список возможных сопряжённых агентов.
Таблица 7
Итак, что же вышло в итоге? Отсортируем по степени возрастания оценки.
1. V3. Проигрывает всем, так как совместима только сама с собой. Повсеместное внедрение на сколько-нибудь заметное число точек присутствия сети TCP/IP приведёт к невиданному раздутию расходной части бюджета, при этом осмысленного числа метрик мы так и не получим, что ясно из таблицы 6. Ну и знание того, что данная технология проталкивается производителем путём бесплатной установки агентов Q2 в целях, как это преподносится, «объективной проверки», приводит нас к мысли, что оплачивать здесь нечего, вендор пытается собрать компенсацию только в виде рекламы физическим лицам и продажи «отчётов» операторам связи. Непригодно ни в каком виде! Бесплатно — пусть стоит. Помогать трудовым рублём — даже не преступление, а ошибка.
2. RFC-4656 (OWAMP). За счёт очевидной однобокости протокола придётся как устанавливать на сети устройства, так и проводить измерения по два раза. Хотя стандарт и реально реализовать на любом устройстве, тем не менее готовых решений пока, прямо скажем, немного. Следовательно вновь «выхожу один я на дорогу, сквозь туман кремнистый путь блестит». Это явно не то, чего хочется в итоге.
3. RFC-2544. Агент-инициатор совместим сам с собой, ну и с UDP-эхо. Всё. Он даже не способен выполнить ICMP-эхо, хотя кажется, что подобное просто нереально! С учётом незначительного объёма собираемых метрик, повсеместное внедрение данного стандарта приводит к бессмысленной трате ресурсов как разработчиков программ, так и операторов связи. «Заяц — вычёркиваем»
4. iperf3. Заслуги у технологии только благодаря таблице 6. Всё остальное — в недостатках. Код системы открыт. Кажется, что вот-вот сообщество разработчиков создаст совместимость и с другими стандартами, это же так просто — пиши себе на языке Си в свободное от работы время, да и в ус не дуй. Но отсутствие даже попытки создать новый модуль намекает нам на то, что в сообществе нет единства, нет плана действий, нет руководителей, и что самое «прекрасное» в FOSS-сообществе — оно не может существовать без перекрёстного субсидирования. Хорошо, когда рядовой администратор пользуется этим инструментом для своих нужд, это позволяет снизить издержки, мы приветствуем такой подход. Но как это решение внедрять на сеть оператора связи? Следует расставить Linux/BSD-машины? Даже для сопряжённых агентов? Явно не разумно.
5. ping. Все поклонники сетевых игр знают эту программу. Все администраторы после настройки сети первым выполняют именно ping. Практически в любой сколько-нибудь уважающей себя системе мониторинга либо встроен собственный ping, либо используется системный. Про языки программирования и говорить стыдно, модуль ICMP-эхо есть практически везде. Любое сетевое устройство, кроме закрытых межсетевых экранов, по умолчанию отзывается на ICMP-эхо. Даже те, в которые встроены технологии V1, V2 и TWAMP! Даже идеальная технология IQM, есть она или нет, неважно, наверняка на 95% должна отзываться! Глупо не пользоваться тем, что есть. Именно за перекрёстное тестирование ping и набрал столь много. Пусть метрики и будут круговые, на первый случай для отслеживания качества этого довольно. Оператор связи уже может смело ставить задачу в отдел разработки или подрядчику по добавлению в систему мониторинга не одного-двух-пяти посылок на один хост, а сразу многих N[s], в соответствии с уже озвученными в книге требованиями. И размер пакета указать! И снять все метрики, а не только состояние «ответил/не ответил»! Разумеется, не с центральной точки! Уважающие системы мониторинга давно умеют исполнять запросы с удалённых точек. Чем такие точки не агенты-инициаторы Q1? Первое рабочее решение!
6. bwping. Но есть лучшее решение, уже в базе имеющее больше баллов, чем свой исторический коллега. Больше, так как умеет принимать в виде настройки параметр скорости B[s]. Можно в качестве базы для будущего глобального отслеживания качества в операторе использовать исходный код bwping. А то и просто его вызывать! Реально? Более чем! Мы уверены, что программистам будет даже интересно! Лучше всего, конечно, добавить в код расчёт RR[p], AMDV[p], OR[p], SR[p], мы видели похожие реализации и находим, что в условиях ограниченности бюджета оператора это более чем разумный выход. В итоге у вас уже почти готовый к применению агент-инициатор Q1. А сопряжёнными Q2 выступают многочисленные разнесённые устройства. Правда, следует заметить, что нагрузочное тестирование может быть затруднено, но подробно поговорим об этом позже. Пока фиксируем в блокнот, что второе рабочее решение превышает по возможностям первое, а стоит примерно столько же.
7. V2. Как ни хорошо ICMP-эхо и его расширенный вариант, как его не дописывай, но когда вам придётся выяснять, почему именно в Зимовники идут потери, а оттуда их нет, почему перекраска трафика происходит только в направлении Богучара, а обратно всё отлично, вам придётся принять нелёгкое решение внедрять протоколы, где видны направления. Эхо-протоколы не дают этой информации, поэтому умные производители, поняв перспективы, реализовали свои собственные недокументированные протоколы измерений односторонних метрик. Что позволяло при наличии на сети устройств нужного изготовителя организовать проверки качества с сохранением результатов либо на самих устройствах, либо в системах управления. Одним из примеров является технология V2. Легко видеть в таблице 7, что она получила более высокую оценку, чем bwping, так как предусматривает расчёт некоторого числа метрик с выделением направления трафика. Однако, означает ли это, что её следует немедленно внедрять, расставляя по сети агенты-инициаторы с указанным заводским клеймом? Нет! И вот почему. Забегая вперёд, скажем, что есть более цивилизованные способы потратить бюджет, и есть более цивилизованные технологии с числом метрик, превышающим V2, кроме того, с альтернативной реализацией, позволяющей выбрать мудро. Подробности будут в разделе критики. Что же касается использования устройств V2, которые уже стоят на сети, то при условии поддержки ими не только эхо-протоколов, а и совместимых технологий (допустим TWAMP), их использование в качестве сопряжённых агентов Q2 не только возможно, а прямо нами рекомендуется! Впрочем, сам протокол V2 не столь уж сложен, и при некотором навыке ваш любимый отдел программирования или ваш любимый производитель ПО вполне способен добавить в существующий агент-инициатор поддержку нужного функционала.
8. V1. Так как производитель V1 со своей технологией получил высокую оценку, отметим, что, как и в предыдущем случае, решение поддержать расчёт односторонних метрик было ими принято задолго до сегодняшнего дня. Поэтому имелись все возможности рассчитать почти весь спектр параметров, за исключением разве что RR[p] и RR[r], что даже удивляет нас, памятуя то, что работать с политиками контроля качества по полю ToS V1 умел хорошо на большом числе моделей. Разумеется, в таких условиях оператор связи был вынужден расставлять в качестве сопряжённых агентов Q2 соответствующие устройства. В документации V1 даже был выработан смешной термин shadow router, как бы намекающий, что хотя тот и находится в тени, но деньги приносит исправно. Правда, не совсем оператору связи, но на что не пойдёшь ради красивых журнальных статей и завиральных идей маркетинга! Но мы не устаём учить всех наших читателей подходить критически к любой технологии. Поэтому в настоящее время рекомендовать данный агент-инициатор никак не можем. Впрочем, если вы уже понесли капитальные затраты и снимаете с этого производителя данные о качестве, то глупо это закрывать вовсе. Это можно и нужно использовать! Допустим, объединяя в общей системе управления. Но вновь ставить — нет и ещё раз нет. Для этого есть другая, более верная возможность. А вот использовать устройства V1 в качестве сопряжённых Q2 — абсолютно верное решение. Можно и нужно. Как в виде TWAMP Session-Reflector, так и с оригинальным протоколом. Благо в России достаточное число талантливых программистов, которые способны и разобраться в существующем и написать новое. Используйте эту Силу, а не выдуманную Лукасом!
9. RFC-5357 (TWAMP). Поскольку стандарт занял высокое место, следует сказать, что разработан он был «Инженерным советом Интернета», безусловно, с оглядкой на V1 и V2. Не удивимся, если теми же самыми людьми. И это разумно. Поскольку даже в существующих реализациях, кроме так называемых "light", которые и реализациями-то назвать нельзя, ибо в сущности это повторение UDP-эхо, расчёт однонаправленных метрик сделан прилежно. А те, что пока не реализованы, допустим RR[p] или AMDV[p] достаточно легко добавить. Почему же в матрице совместимости у него всего три отметки, но при этом первое место? А потому что протокол документирован! Что, читатель? Вы удивлены? Вовремя сказанная шутка — это глоток свежего воздуха! На самом деле, хотя документирование очень важно, но всё-таки в весовых коэффициентах таблицы 7 не предусмотрено. Дело в другом — в технологиях V1 и V2 реализованы TWAMP-совместимые сопряжённые агенты. Не просто ответ на эхо, а полноценные, с управляющим соединением. Равно как и должна быть сама эталонная реализация TWAMP. Поэтому там больше баллов, чем в обратную сторону. Ну и никто не мешает сделать TWAMP-совместимым наш идеал на предпоследней строке. Именно эти три оценки и дали преимущество перед недокументированными протоколами, всё строго математически. Остаётся сказать, что внедрять на сети в качестве базы стоит именно совместимые документированные протоколы, обеспечивающие расчёт однонаправленных и двунаправленных метрик. Таков TWAMP. Записывайте его в качестве обязательного требования к агенту-инициатору Q1, а благие пожелания для будущей гибкости, в частности поддержку эхо-протоколов, будем добавлять в лидера сезона таблицы 7.
10. IQM. Идеал, он и есть идеал. Есть ли он, нет ли его, не столь важно. Важно понимать, к чему мы стремимся в итоге. А стремимся мы к поддержке в одном агенте-инициаторе Q1 как собственных протоколов, так и многочисленных сторонних, от ICMP-эхо и UDP-эхо, что просто и делается чуть не за один день, до сложных TWAMP, V2, V1, что уже не так-то и просто, но мы верим в силу русских связистов и программистов. А зачем мы к этому стремимся? А затем, чтобы в одном агенте-инициаторе объединять множество различных технологий. Пусть на сети будет лишнее устройство, измеряющее метрики качества! Да, это затраты. Но чем больше сторонних технологий будет поддерживаться, тем большим числом устройств, уже расположенных на сети, можно будет воспользоваться, как сопряжёнными агентами Q2. Вот он — наш идеал. Затраты разумны, а итог максимально полон. Более того, эти же агенты-инициаторы можно сделать ещё полезнее, о чём мы напишем ниже.
Сводим всё вышесказанное в два простых требования к реализации протоколов тестирования сетей TCP/IP с расчётом максимального числа метрик. Вначале требования к реализации для агента-инициатора:
Требование 7
Прикладное программное обеспечение, используемое для расчёта метрик качества на сети TCP/IP, установленное на агенте-инициаторе Q1, должно в обязательном порядке поддерживать один из эхо-протоколов (предпочтительно UDP, либо в крайней случае ICMP), а так же RFC-5357 (TWAMP) как минимум в варианте с управляющим соединением.
Прикладному программному обеспечению, используемому для расчёта метрик качества на сети TCP/IP, установленному на агенте-инициаторе Q1, крайне желательно поддерживать протоколы V1, V2 в целях использования уже установленных на сети устройств в качестве сопряжённых агентов.
Прикладному программному обеспечению, используемому для расчёта метрик качества на сети TCP/IP, установленному на агенте-инициаторе Q1, желательно поддерживать иные протоколы, имеющие расширенный набор метрик качества, даже если для этого требуется установка отдельных сопряжённых агентов Q2.
Теперь требования для сопряжённого:
Требование 8
Прикладное программное обеспечение, используемое для расчёта метрик качества на сети TCP/IP, установленное на сопряжённом агенте Q2, должно в обязательном порядке поддерживать либо ICMP-эхо, либо UDP-эхо.
Прикладному программному обеспечению, используемому для расчёта метрик качества на сети TCP/IP, установленному на сопряжённом агенте Q2, крайне желательно поддерживать протокол RFC-5357 (TWAMP) в целях расширенного сбора метрик качества.
Прикладному программному обеспечению, используемому для расчёта метрик качества на сети TCP/IP, установленному на сопряжённом агенте Q2, желательно поддерживать протоколы V1, V2 и иные в целях расширенного сбора метрик качества в случае необходимости.
На наш взгляд, всё вышесказанное следует переварить в спокойной обстановке. Отодвинем профессию в сторону, прочь книжки, прочь сомнения. Скачем веселиться к князю Орловскому, там уже началось, слышите?
Эту чашу пью за дружбу нашу,
За огонь во взорах, за сердечный порох.
Эту чашу пью за встречу нашу
За веселье до утра!!!
Спасибо за чтение
Вернуться к книге